
Claude Code 安装后打不开:先检查 PATH、架构与版本
用现有 CLI 记录版本和本机命令路径,为 Windows 安装加入可复制的独立检查。
阅读文章正在打开页面…
正在加载内容,请稍候。
从 API Key、Base URL 配置到首次调用,按工具查找接入步骤与常见报错;也可浏览图像、视频、自动化和办公任务教程。
获取 API Key1450 篇教程,当前显示第 1393–1440 篇。选择页码继续浏览,或切换任务主题。
用现有 CLI 记录版本和本机命令路径,为 Windows 安装加入可复制的独立检查。
阅读文章用现有 CLI 记录版本和本机命令路径,为 Windows 安装加入可复制的独立检查。
阅读文章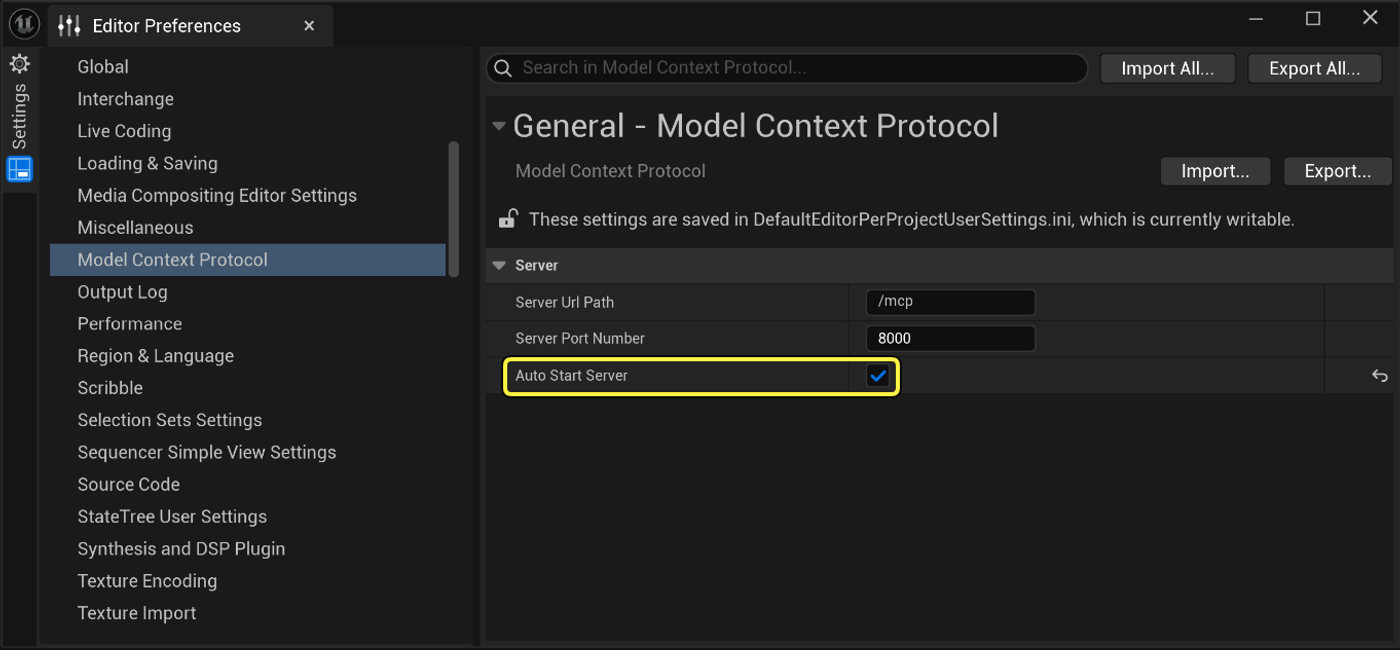
Claude Code Unreal MCP 教程按 UE 5.8 官方 Experimental 插件配置本机服务并生成 .mcp.json。先只读确认真实工具 schema,再串行搭建方块练习场景;页面没有执行编辑器或提供已生成游戏。
阅读文章
Cline 配置 Claude API 先在当前版本选择匹配的 Provider,填写 Key、地址和模型,再分别验证文本回复、文件编辑和终端工具任务。保留修改差异与平台记录,区分模型接口可用和整套 Agent 任务完成。
阅读文章
编程模型测试集用数量解析和重试间隔两道 Python 修复题,固定允许修改的文件。独立测试由作者保留,先审代码再隔离运行;十二项测试只验证这两份函数合同。
阅读文章
在Cursor当前支持的OpenAI覆盖入口,填写同一服务的Key、基础地址和准确模型ID,再新开聊天验证真实路由。覆盖OpenAI地址不保证Anthropic模型转发,Tab也不会因此改用自备Key;保存成功后仍需单独测试代码任务。
阅读文章
Dify 知识库 RAG 接入先配置回答 LLM,再单独配置向量索引与 rerank。用短售后文档检查命中文本、答案和无资料问题,聊天成功不能替代知识库索引与来源验收。
阅读文章
FastAPI AI 图片接口用 UploadFile 接收文件,限制实际字节并完整解码,再创建持久任务交给 worker。先验证存储与归属;BackgroundTasks 是进程内机制,不能代替长期可恢复的生图队列。
阅读文章
区分 FinGPT Forecaster 的本地 Llama/LoRA 与外部摘要层,保留原始金融资料与模型输出,用独立 Python 脚本调用兼容 API,避免伪装统一原生配置。
阅读文章
FinRL 回测报告摘要教程先完成经典 FinRL 的训练和回测,再将已有记录保存为 backtest_metrics.txt。独立 tokenba_summary.py 读取模型 Key 与型号并生成解释;它不执行训练、不计算收益,也不能补写缺失指标。
阅读文章
Google官方Gemini Key、Google原生generateContent、Google的OpenAI兼容地址与apizt的/v1是不同配置分支。先按Key签发平台选路线,再配匹配的协议地址与模型ID;最小文字请求通过后再验证图片、工具和流式。
阅读文章
Gemini 原生生图 API 的 generateContent、Interactions 和 Images 兼容接口使用不同请求与返回结构。先确认当前入口支持的协议和型号,再解析对应图片字段;本页没有实测 apizt 原生路径。
阅读文章
Go 接入 apizt 使用 openai-go/v3,显式设置 BaseURL、APIKey 与 WithMaxRetries(0)。先验收普通 Chat 请求和 context 超时,再逐项添加流式、工具或视觉输入。
阅读文章
GPT Image 1.5 程序迁移到 GPT Image 2,核对 Images 生成与编辑接口、input_fidelity、尺寸和 b64_json。附请求代码、迁移清单与已有编辑记录。
阅读文章
AI 蒙版局部重绘先建立与原图同画布的 PNG,让待编辑区域透明,并检查宽高和格式。mask 是生成引导,可能影响边界外;需要严格保留原像素时,将合格区域重新合成到原图。
阅读文章
图生视频教程从一张可用图片开始:核对模型的图片输入、比例和时长要求,提交后保存任务 ID,再查询状态并下载结果。客户端超时先查已有任务,按对应接口检查失败原因,避免重复提交。
阅读文章
JSON Schema 结构化输出先约束字段与类型,再用本地规则核对事实和业务关系。本页比较 JSON Mode 与 strict,处理 null、额外字段、拒绝和截断,不把结构合法当成内容真实。
阅读文章
LangChain 接入 apizt:ChatOpenAI、LCEL 与流式验证。保留固定版本与完整 AIMessage,不要立刻转成纯文本。 保留原有配图与资料,补充实际结果和明确测试范围。
阅读文章
LangGraph 工具调用教程:库存查询与 tool_call_id 回传。原流程继续核对 ToolMessage 的 tool_call_id 与循环上限。 保留原有配图与资料,补充实际结果和明确测试范围。
阅读文章
LiteLLM 接入 apizt 的 SDK 路径使用 openai/准确ID 与 /v1 api_base,上游收到的仍是准确模型 ID。Proxy 的模型 alias 和两层 API Key 要分别核对,再用固定分类任务验收。
阅读文章
LlamaIndex 接入 apizt 使用 OpenAILike 配置 api_base 与模型信息。本页用两段资料和 SummaryIndex 核对答案出处,不调用 Embedding API;生成连接和大型向量检索要分别验收。
阅读文章
长文引用怎么测试,使用带 ID 的固定片段,分别检查答案成立与引用支持。无答案应保留未知,未决矛盾并列说明;120 段是测试文档长度,不是模型上下文规格。
阅读文章
大模型成功任务成本用已核对的全部尝试费用除以通过验收的任务数,失败与重试也计入。缺少实扣时保留未知或明确估算,不能把公开最低报价写成实际账单。
阅读文章
大模型延迟怎么测,非流式请求记录完整响应总耗时,TTFT 需要独立接收流式事件。成功任务速度与全部尝试等待时间分别统计;少量样本的 P95 和失败等待不能当成通用速度排名。
阅读文章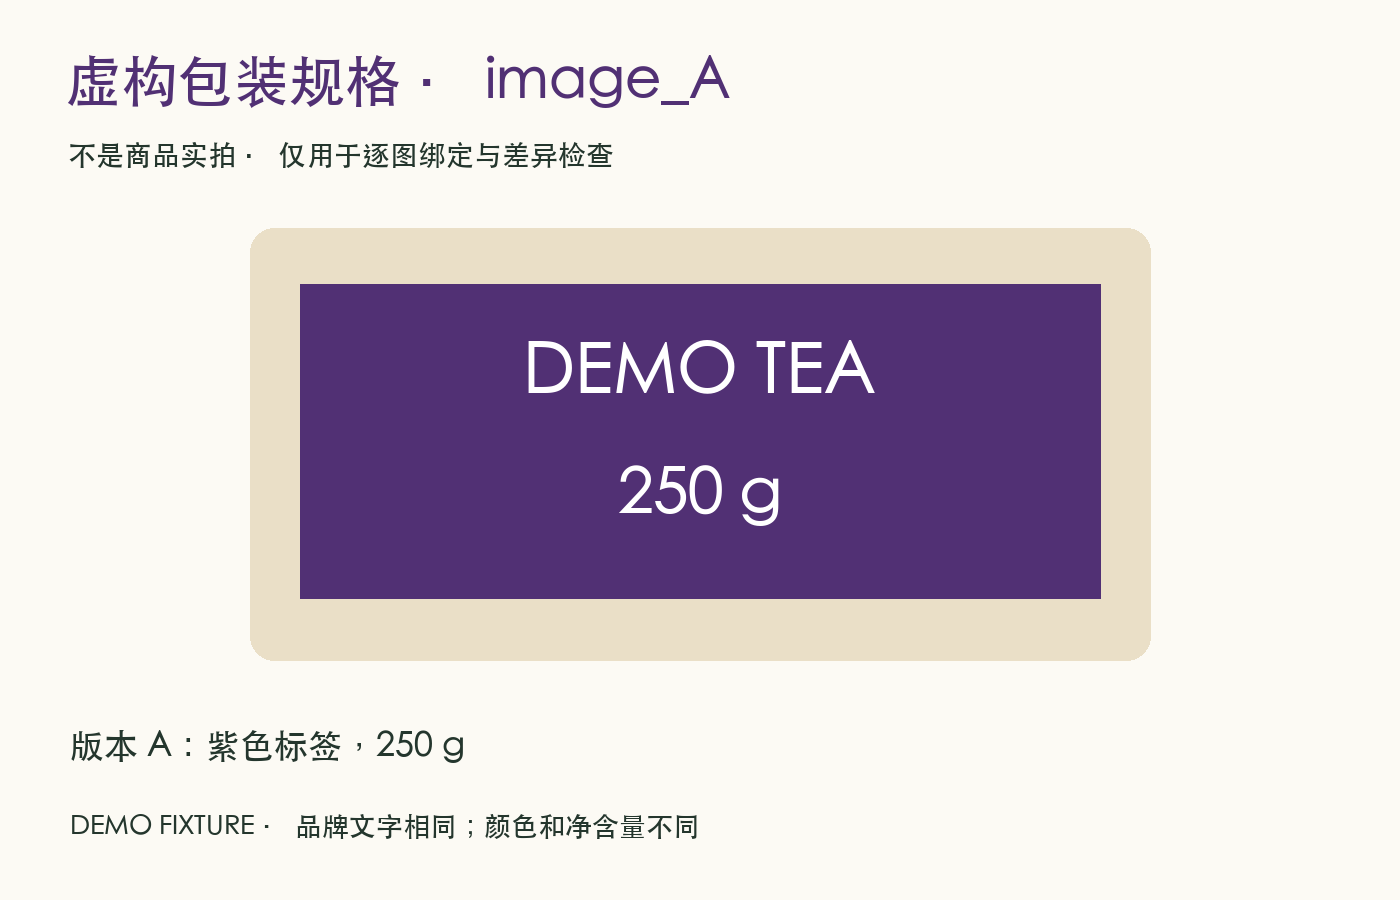
多图对比 API 先标注 image_A、image_B,逐图提取字段,再让差异引用正确图片与原文证据。相同项和不确定项分别保存;多图理解不等于多图生成或商品真实性判断。
阅读文章
n8n AI Agent 工具调用先确认 Chat 模型与 /v1 凭据,再连接只读订单 Workflow Tool。查看子工作流真实输入输出,分别验收工具执行与最终回答;模型列表加载不表示 Agent 回合已成功。
阅读文章
n8n 电商内容自动化先固定 SKU、材质、尺寸与不变卖点,再生成可审核的文案和图片提示词。工作流不直接生图或发布商品;先用两条虚构样本验收字段,再替换成自己的资料。
阅读文章
n8n Google Sheets AI 教程用固定 qr_id 对应原文、分类和摘要,Google Sheets 节点读写表格,HTTP Request 调模型。先核对输入版本并人工批准,再写入目标记录;下载材料未连接真实 Google 账户。
阅读文章
n8n AI 生图工作流先从表格的一行请求 Images 接口,用 row_id 对应响应,再将 b64_json 转为二进制图片。保存成功后回写地址,人工审核后标记完成;超时任务先核查原记录。
阅读文章
n8n 视频生成工作流要将创建与等待分开,先把 task_id 写入自己的持久记录,再使用 GET 查询。下载模板只查询一个已有 ID 一次;循环、Wait、总时限和人工验收按正文另行配置。
阅读文章
Next.js AI 生图 API 把 Key 留在服务端,浏览器只向自己的 Route Handler 提交业务任务。输入、身份和额度通过后交给持久 worker,保存原文件并更新状态;202 响应本身不会自动生成可恢复队列。
阅读文章
Node.js 图片 API SDK 教程在服务端保管 Key,用 images.generate 生图、toFile 上传原图并调用 images.edit。默认 dry-run,显式 --run 才发送;Base64 图片和元数据保存后再验收。
阅读文章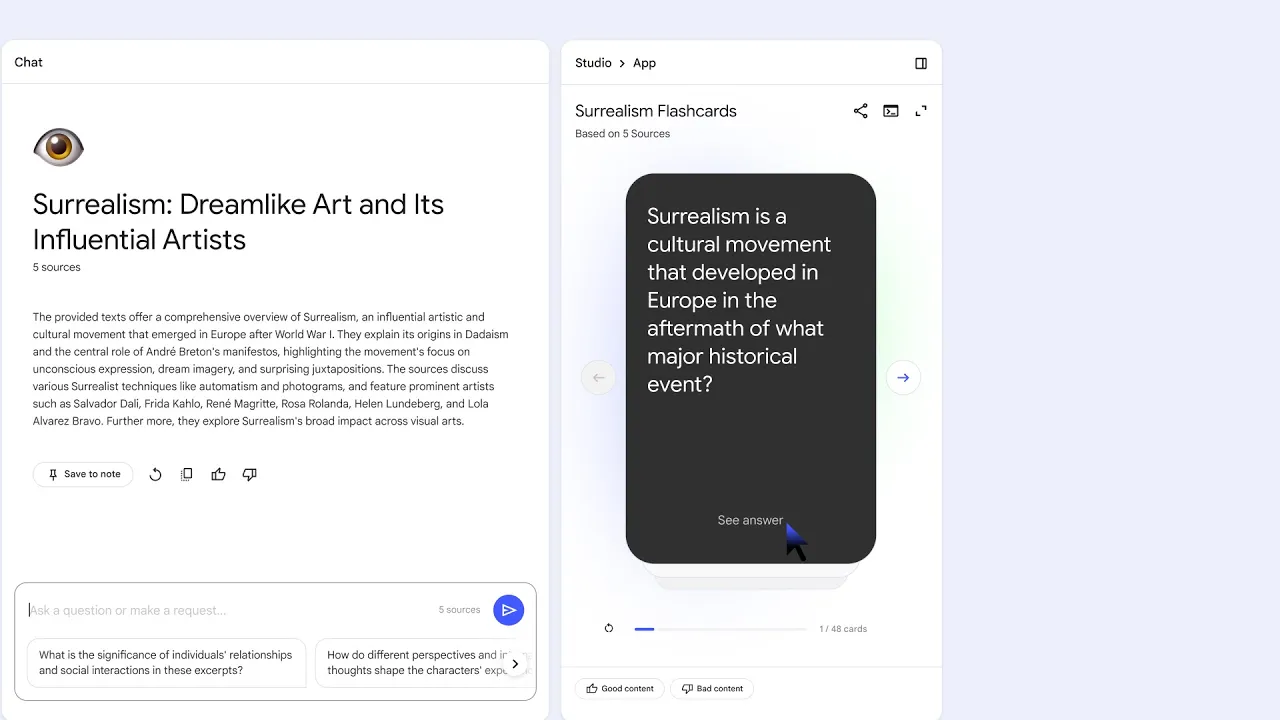
NotebookLM 抽认卡先导入一份干净来源,在 Studio 设置难度与重点后生成。先回忆再翻答案,解释回到来源核对,错卡重新练习;官方帮助明确提供抽认卡 CSV,不能据此推断测验也有相同导出。
阅读文章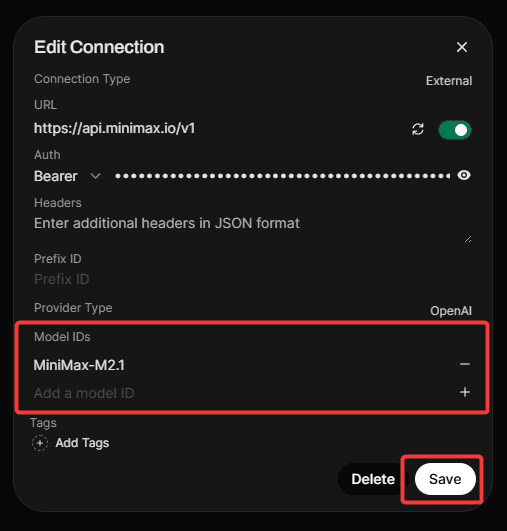
Open WebUI RAG 接入 apizt 先在 Admin → Connections 配置聊天地址与 Key。文档 Embedding 在 Admin → Documents 单独设置,更换向量模型后重新索引,再核对检索来源和答案。
阅读文章
OpenAI Agents SDK 接入 apizt 要把自定义 AsyncOpenAI 包装成 OpenAIChatCompletionsModel,而不是只更换默认模型地址。固定库存工具用于核对提案、实际执行、结果回传与最终回答。
阅读文章
OpenAI SDK 自定义 Base URL 时同时设置目标服务的 API Key 和准确模型 ID。本文提供 Python 与 Node.js 最小请求,使用 /v1 根地址并检查有效文本、错误响应和用量记录,再扩展到流式与业务代码。
阅读文章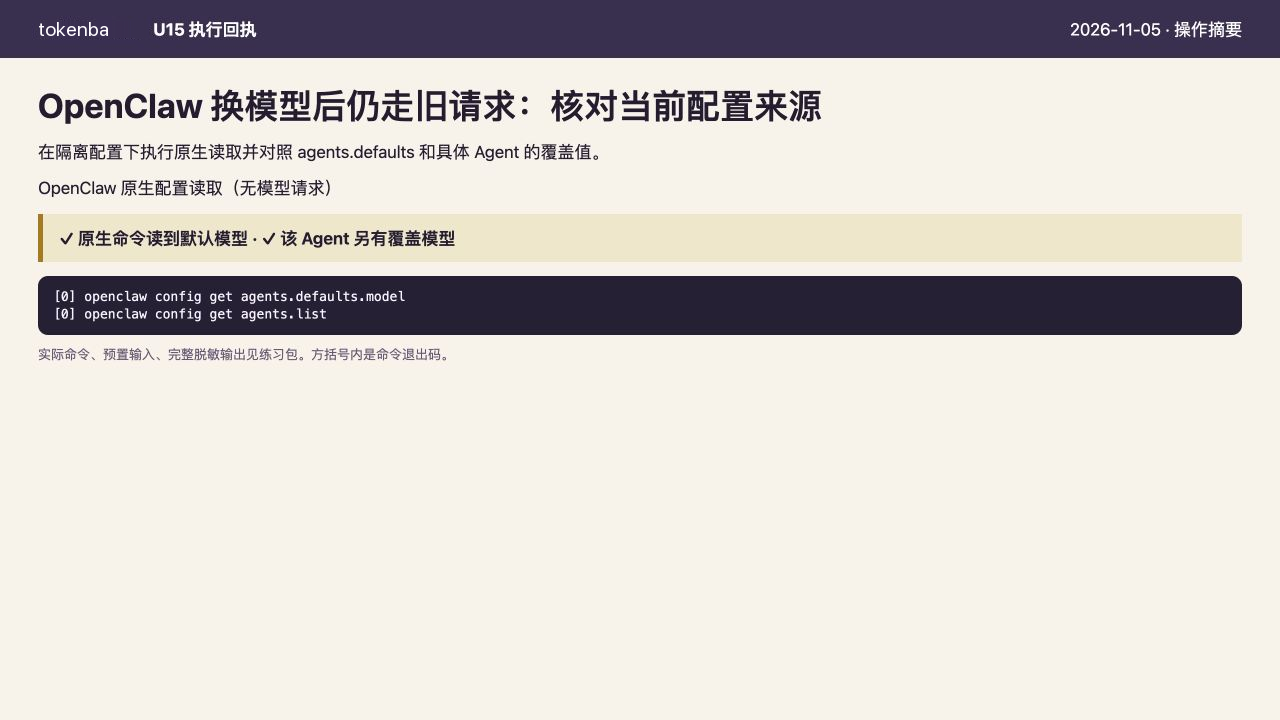
在隔离配置下执行原生读取并对照 agents.defaults 和具体 Agent 的覆盖值。
阅读文章在隔离配置下执行原生读取并对照 agents.defaults 和具体 Agent 的覆盖值。
阅读文章
第一次用OpenCode V2,先分清V1/V2安装与配置,再在独立练习中选择模型和Agent、审阅一个文件的改动并运行原测试。包含版本、权限、费用与未实测范围说明。
阅读文章
Prompt Caching 先把不变规则和资料放在提示词前面,再用重复请求观察服务端 usage。缓存读取、写入与控制台费用要分别核对,不能仅凭响应更快判断命中或折扣。
阅读文章
Python 图片 API SDK 教程把文字生图、二进制原图上传和结果保存连成一个脚本。Key 从自己的环境变量读取,先 dry-run 再主动发一张小样;保存文件后仍需核对图片与实际费用。
阅读文章
先按 Qlib 原生 workflow 完成数据、LightGBM 与回测,再将日期、基准、费用和指标整理到独立摘要层。API Key 不会自动替换 Qlib 的训练模型。
阅读文章
设置 LLM_PROVIDER=custom 与 CUSTOM_API_URL、CUSTOM_API_KEY、CUSTOM_MODEL,核对实际容器和后台覆盖,用研究报告验证模型路由,交易凭据单独管理。
阅读文章
Reasoning Effort 怎么对比,先保存真实协议与原生预算,再在同一型号内做成对测试。跨厂商的 medium 不是统一算力刻度,输出上限与推理占用也要按当前 usage 核对。
阅读文章
Rerank API 中文教程用 query、documents 与 top_n 重新排列候选资料,再按 results[].index 找回原输入。固定请求可下载复查;relevance_score 是相关性分数,不是答案正确率。
阅读文章
Roo Code 停服迁移先整理存量模型配置与规则。官方已宣布 2026-05-15 结束相关产品并归档扩展仓库;历史 OpenAI Compatible 字段用于核对,新流程在 Cline 重建后要重新验证工具任务。
阅读文章
同档大模型怎么对比,先按用途确定候选组,再固定输入、协议、预算与验收合同。模型定位不表示能力完全相等;通过率、总耗时和实际费用分别比较,不混合档次制造排名。
阅读文章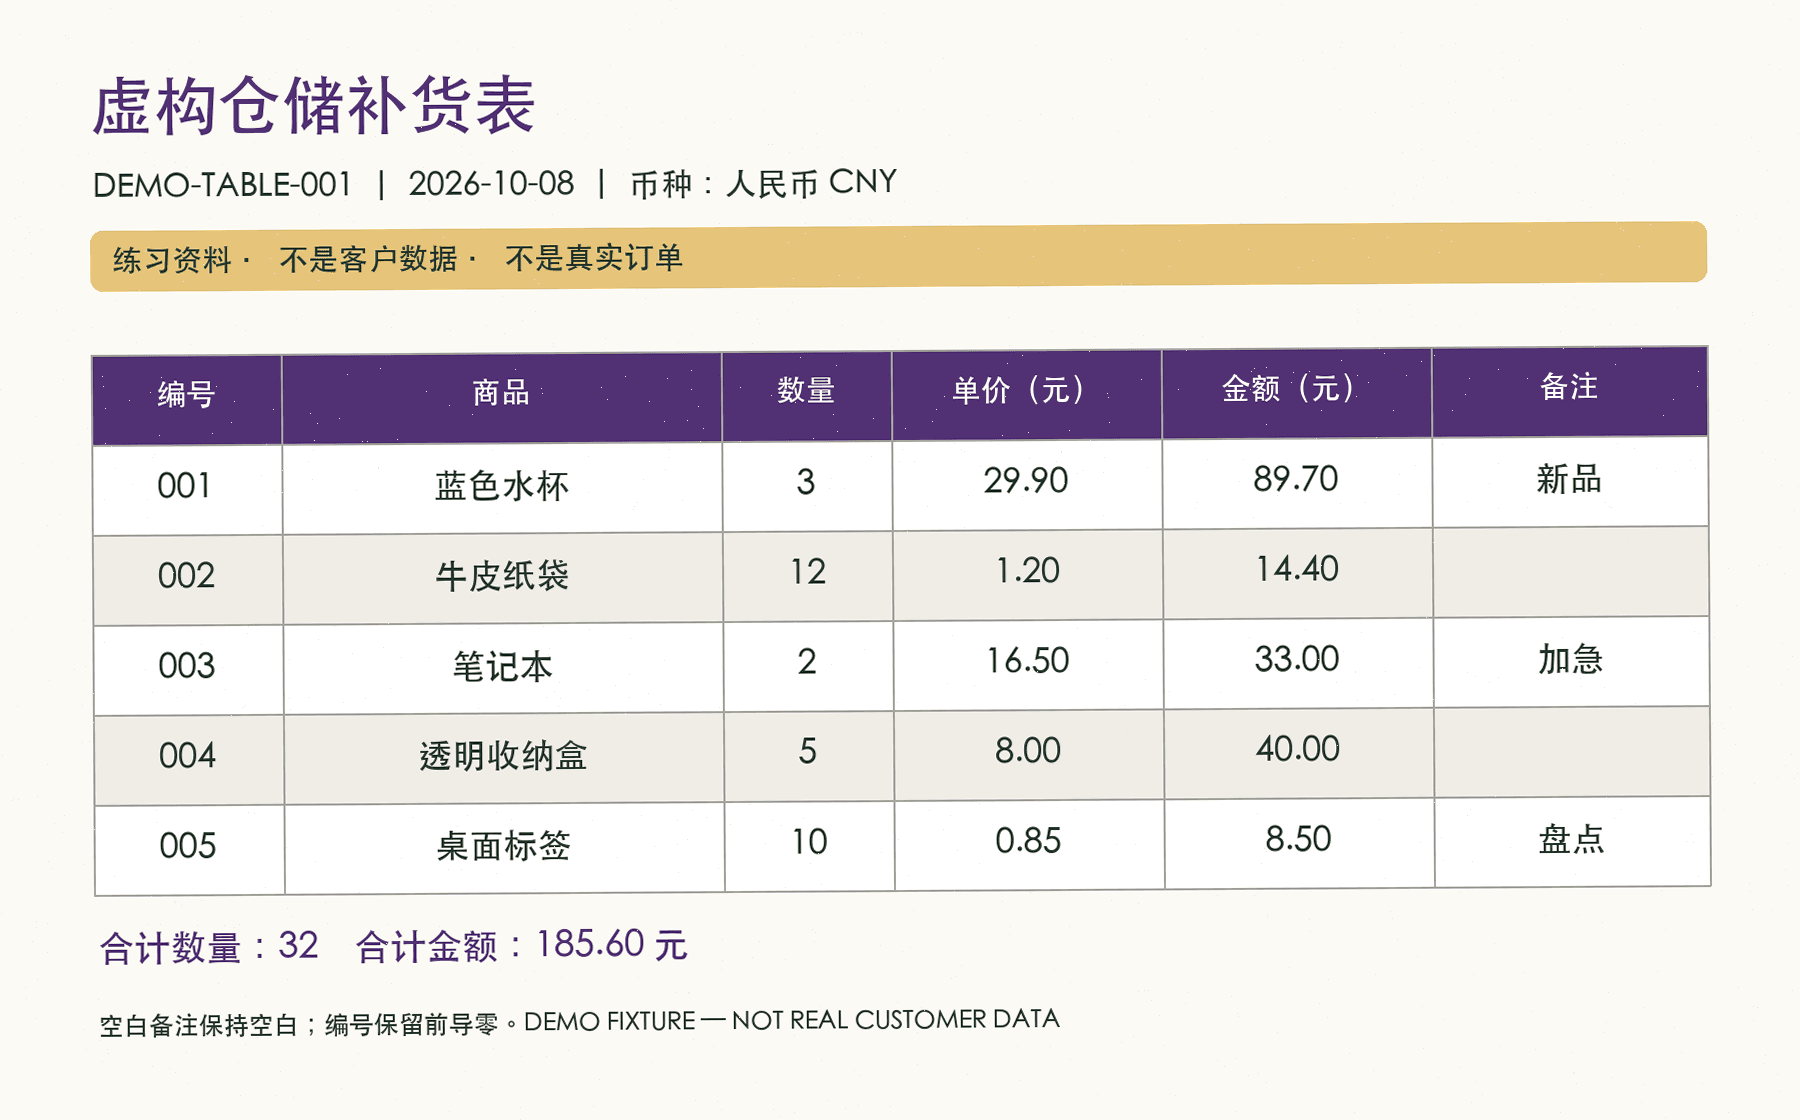
扫描 PDF OCR 先确认文档没有可用文字层,再逐页渲染图片并保留 page_id。按页识别文字与表格,保存不确定字段和失败状态;图片输入能力不能自动证明原生 PDF 上传也支持。
阅读文章注册后创建 apizt API Key,选择客户端和模型,再生成接入配置。从一次简单请求开始,按实际用量付费。
在控制台创建令牌,选择需要使用的模型权限。
按工具要求填写 API Key、接口地址与模型 ID。
确认收到有效结果,再到控制台查看用量与费用。