
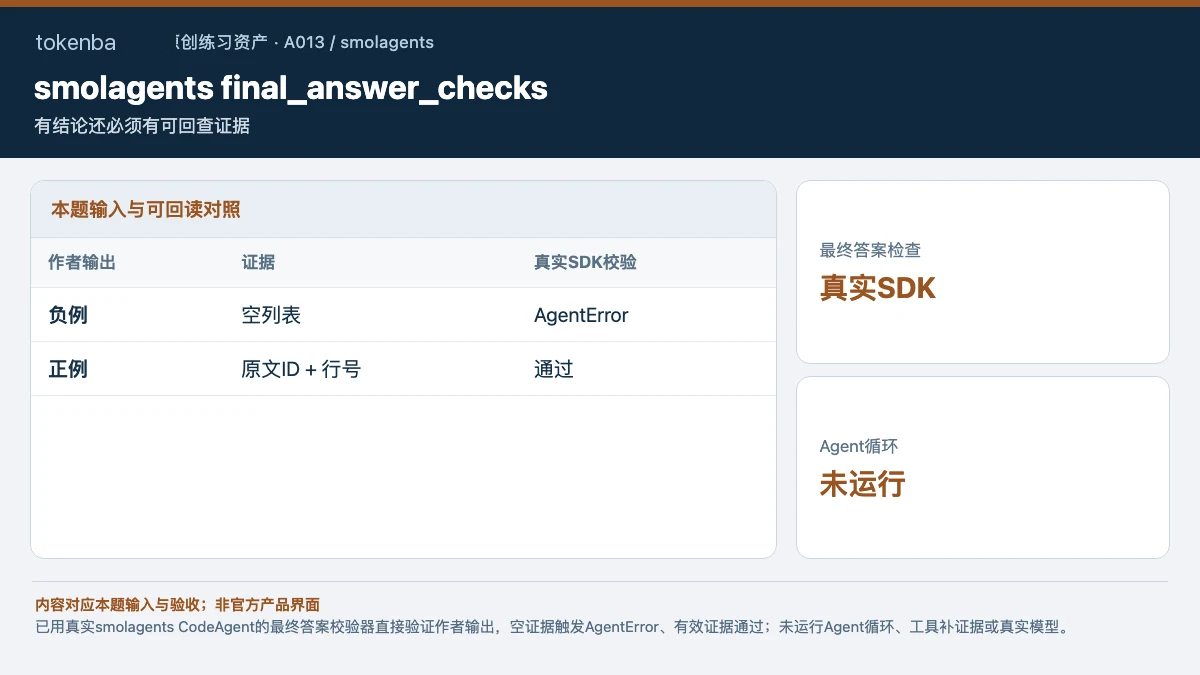
smolagents final_answer_checks:没有证据字段就退回 Agent,停止把草稿当完成
创建CodeAgent时传final_answer_checks,让回调验证answer/evidence并兼容当前SDK的agent关键字参数。空证据应阻止完成,补证据后必须有真实读取事件且引用可回读;直接调用校验器不等于Agent已自动补证据。
阅读文章正在打开页面…
正在加载内容,请稍候。
从 API Key、Base URL 配置到首次调用,按工具查找接入步骤与常见报错;也可浏览图像、视频、自动化和办公任务教程。
获取 API Key1450 篇教程,当前显示第 721–768 篇。选择页码继续浏览,或切换任务主题。
创建CodeAgent时传final_answer_checks,让回调验证answer/evidence并兼容当前SDK的agent关键字参数。空证据应阻止完成,补证据后必须有真实读取事件且引用可回读;直接调用校验器不等于Agent已自动补证据。
阅读文章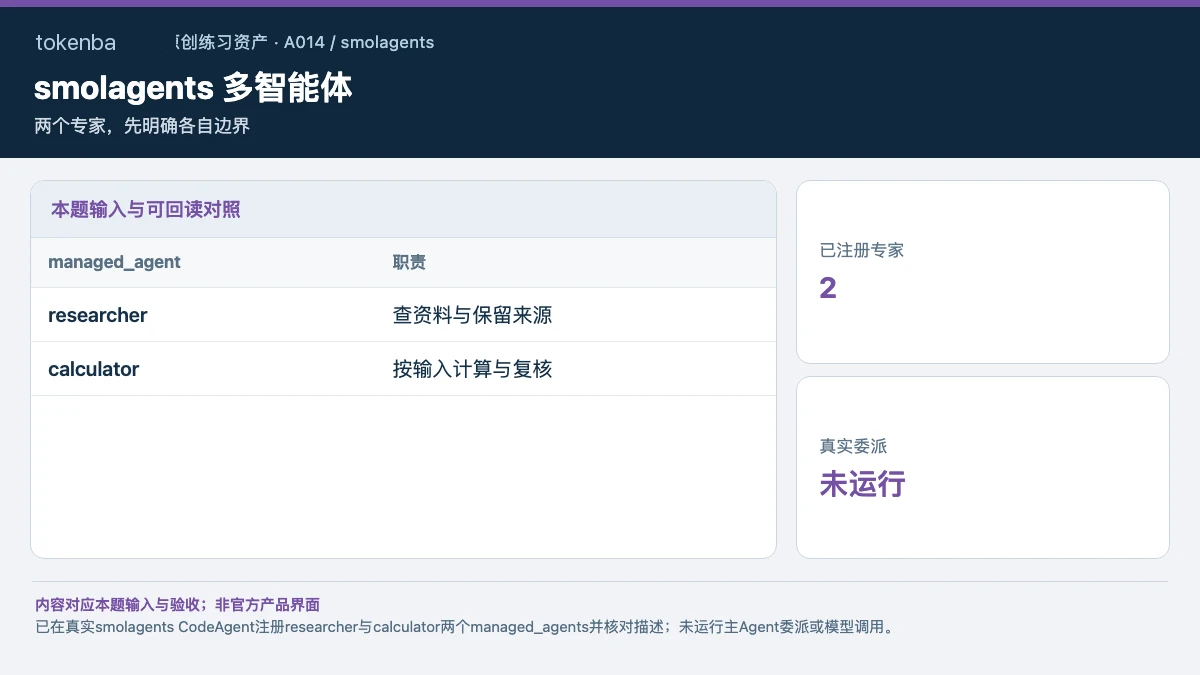
为researcher与calculator设独立名称、任务描述和返回合同,再交给主Agent的managed_agents。每次委派只传所需输入,回收后分别核对来源行与Decimal金额;注册成功不能代替真实委派和返回记录。
阅读文章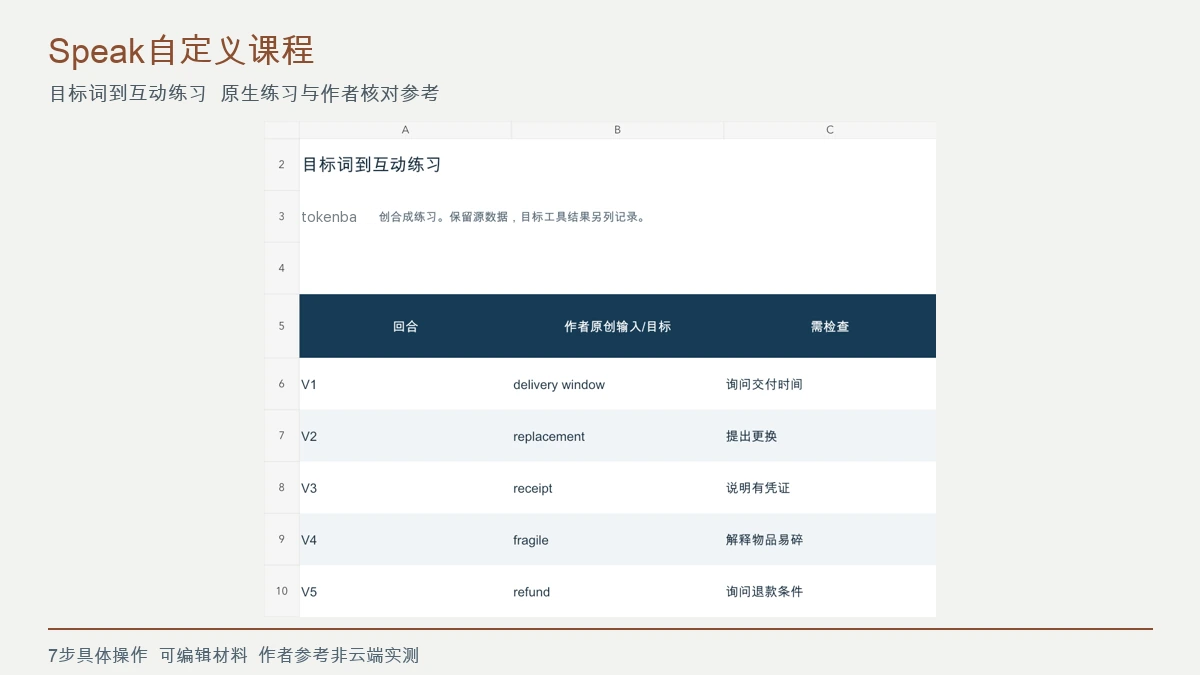
自定义课程要检查目标词是否进入可做的互动任务;只在目录列了词不算覆盖,缺项明确补练。
阅读文章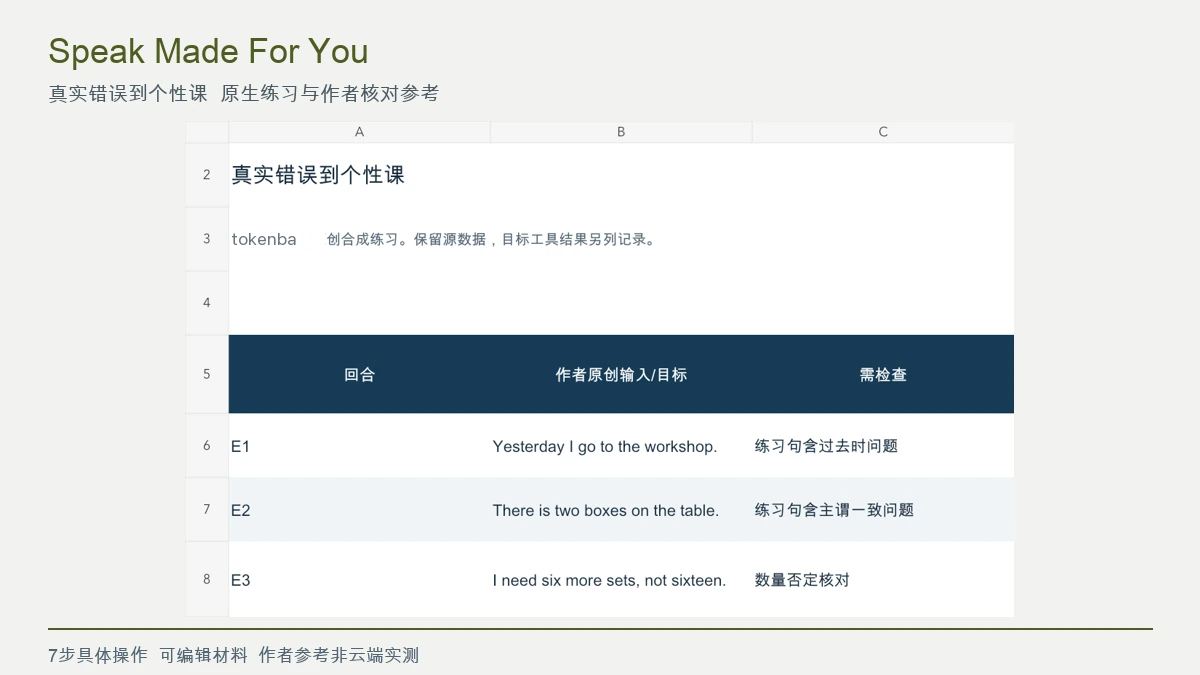
Made For You必须来自使用者真实练习;把原生个性课逐项映射到实际说法,没有触发就保留未触发。
阅读文章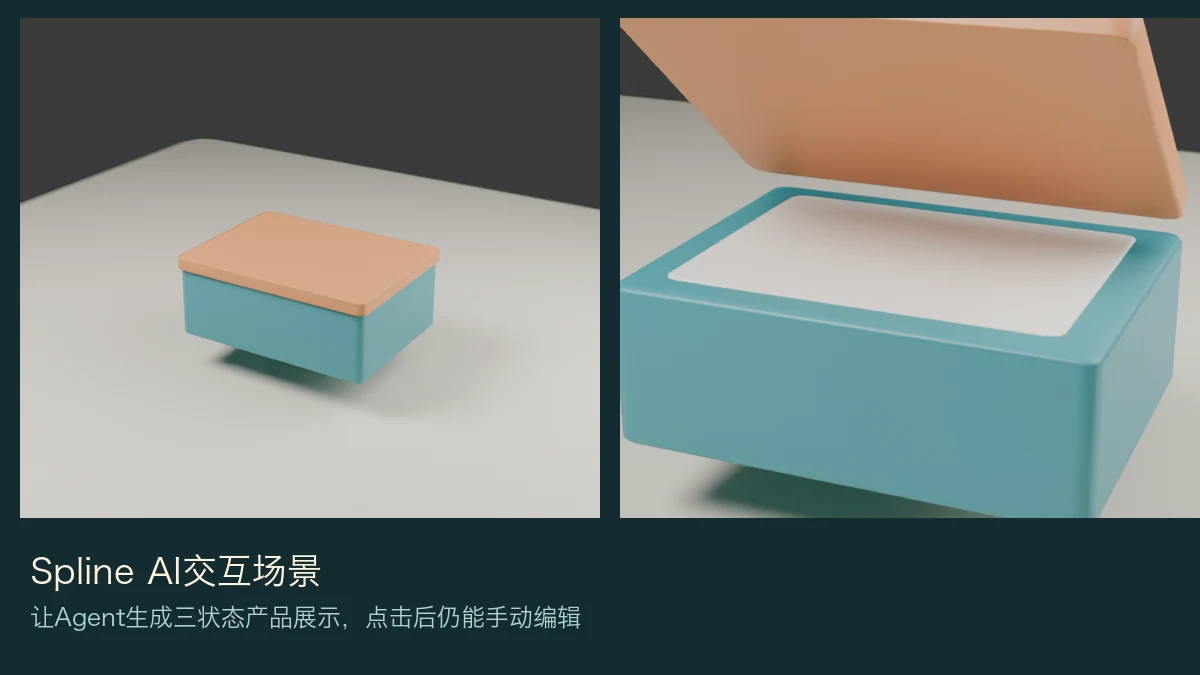
先给Agent明确default→selected→open→default状态链,生成后逐状态检查对象和点击事件。完整点击三次后手动修改选中态颜色,再走一圈确认仍可编辑、可返回且盖子不穿底座。
阅读文章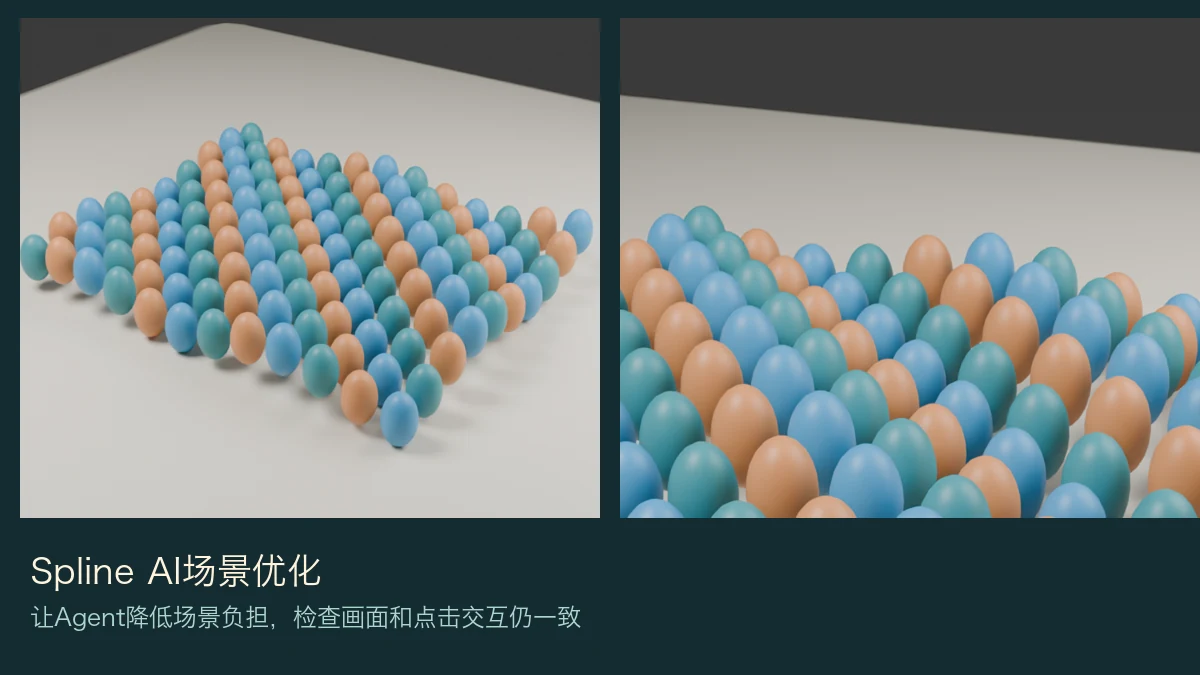
固定设备、窗口和机位,保存原工程及Performance读数,再要求Agent减少重复几何或材质负担。处理后在同条件重测性能,并逐项比较画面和点击链;不能把场景换成截图后声称优化成功。
阅读文章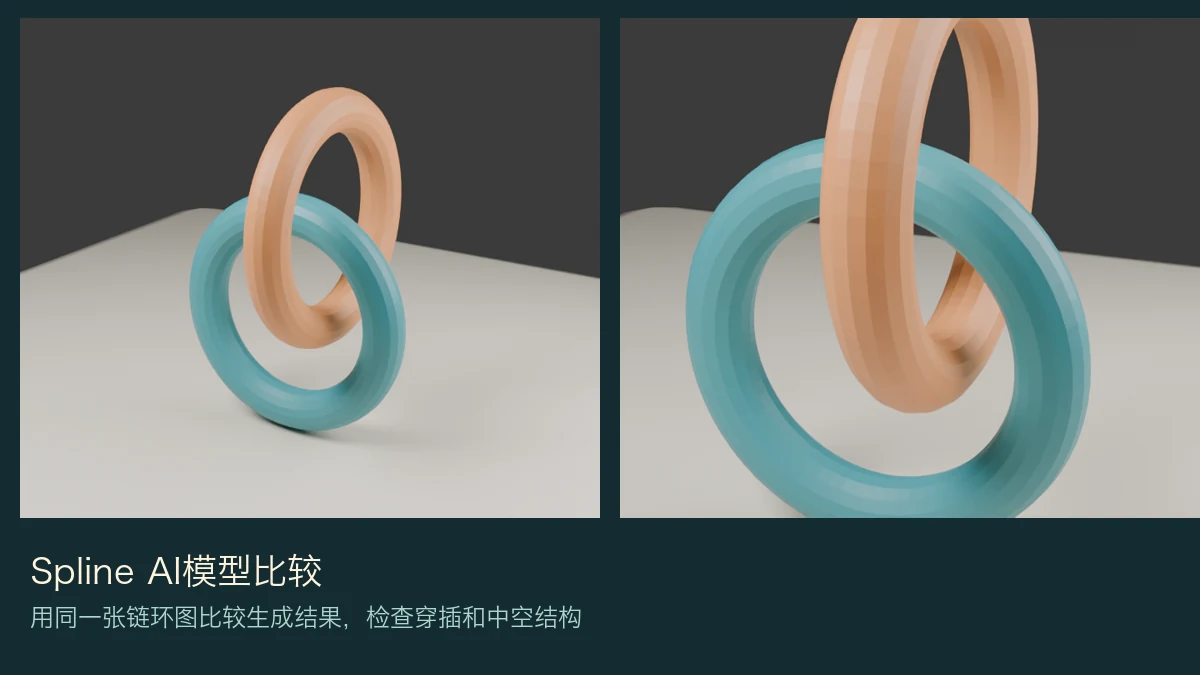
在 Spline Generate 对同一链环参考分别选择两个实际可用模型,保持图片和文字约束一致。旋转两版预览并检查侧面、背面和中空孔,保存模型切换与失败结构,不能只看正面。
阅读文章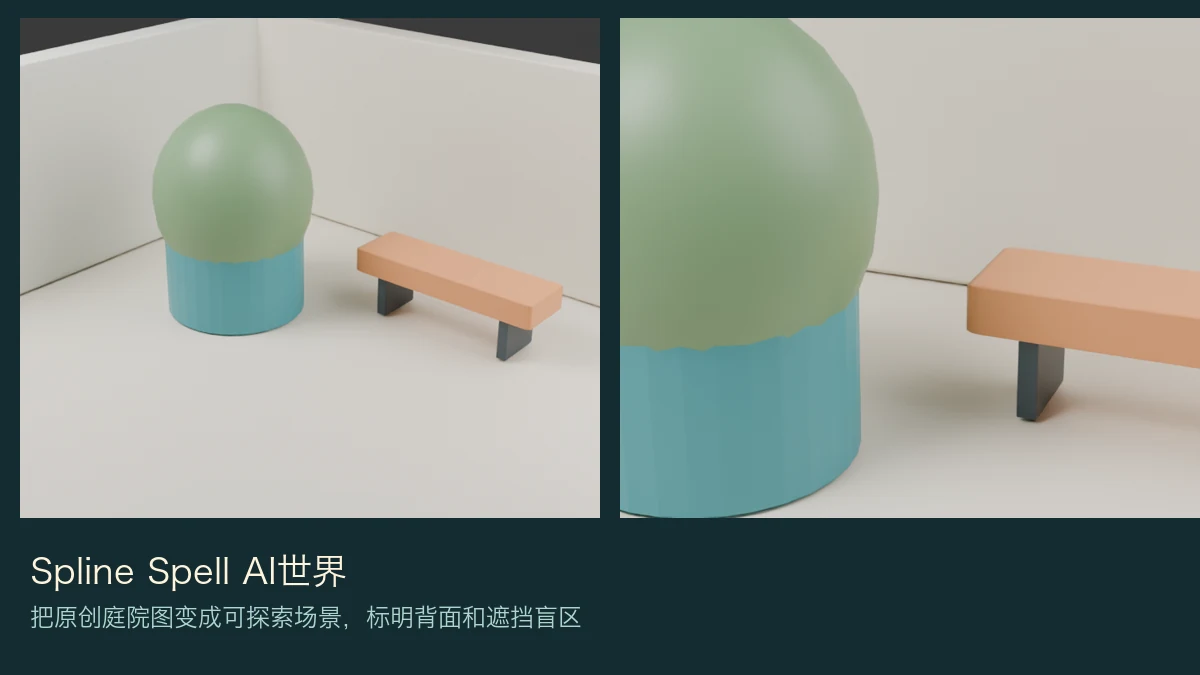
在 Spline Spell 用同一原创庭院图生成可探索世界,沿原机位附近和遮挡后方分别观察。把原图可见区域与新增未知背面标清,记录漂浮、拉伸和破洞,再判断可用漫游范围。
阅读文章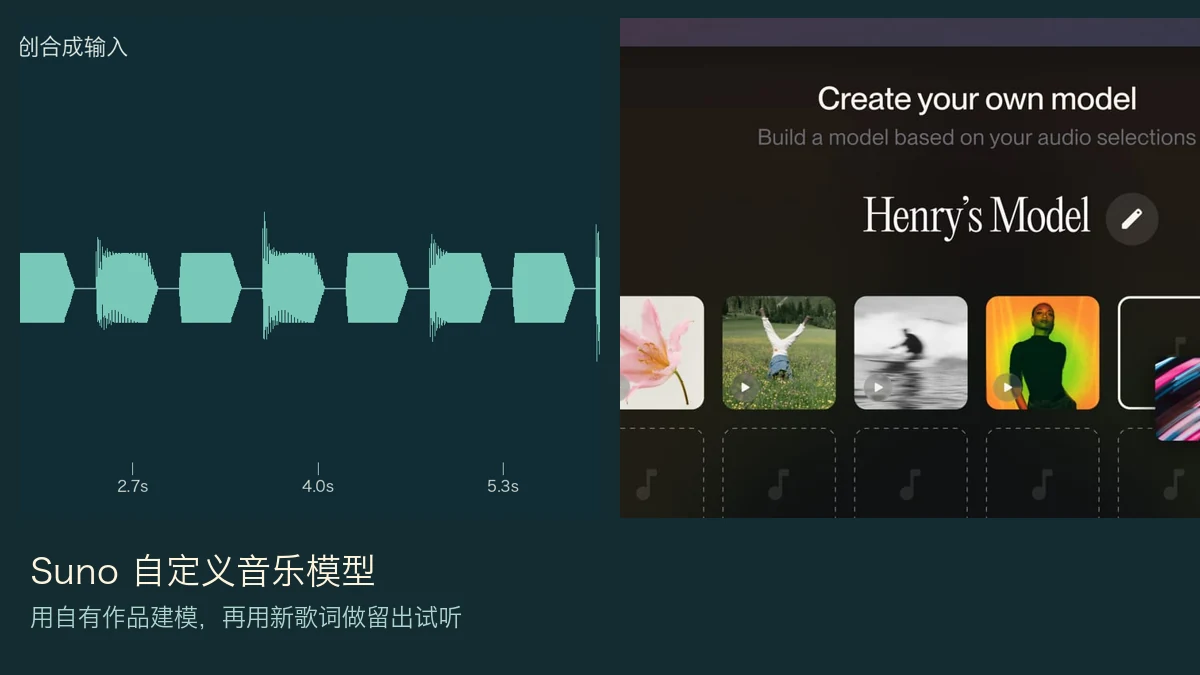
先核对建模资格与作品权属,把训练作品和新歌词留出项分开,再建立模型并保存真实标识。用未参与建模的歌词试听结构与声音;不能由功能存在推出该用户账号已可用。
阅读文章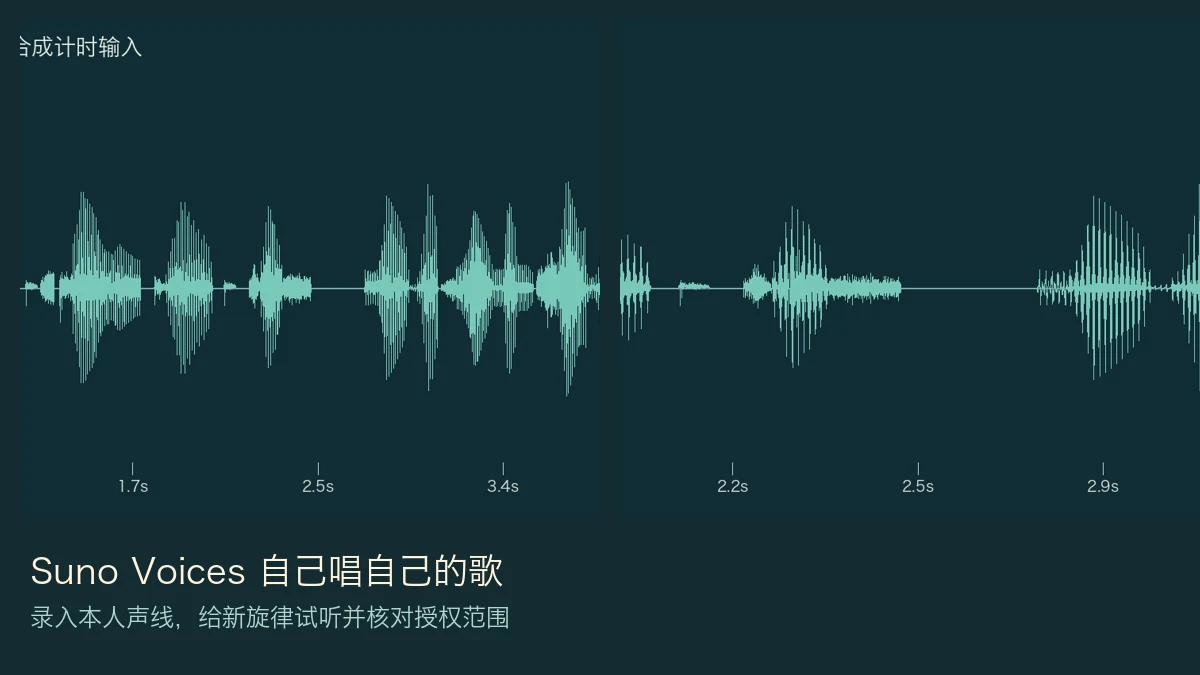
在当前 Voices 入口上传或录制本人声音,朗读实际核验短语并裁切代表片段,再用新旋律试听。保存原生授权与可用范围记录;包内练习材料不能代替本人核验或证明创建成功。
阅读文章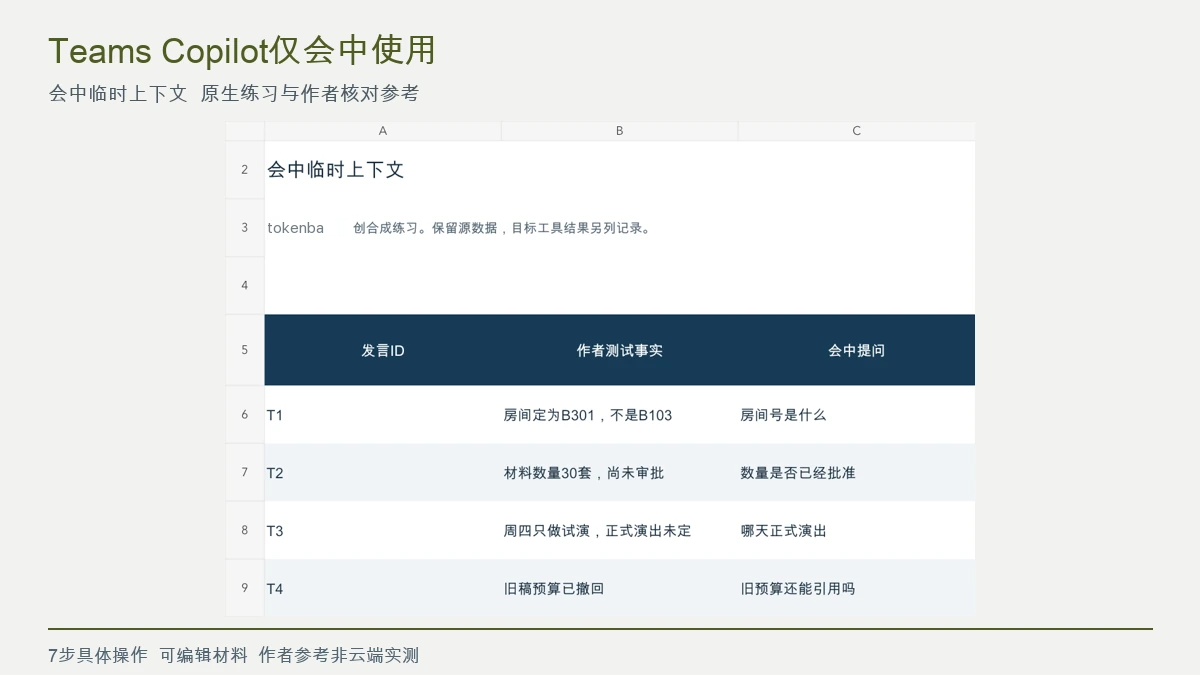
Only during the meeting的验收需要实际会中答复和会后可用性对照;临时上下文不应被误说为永不处理语音。
阅读文章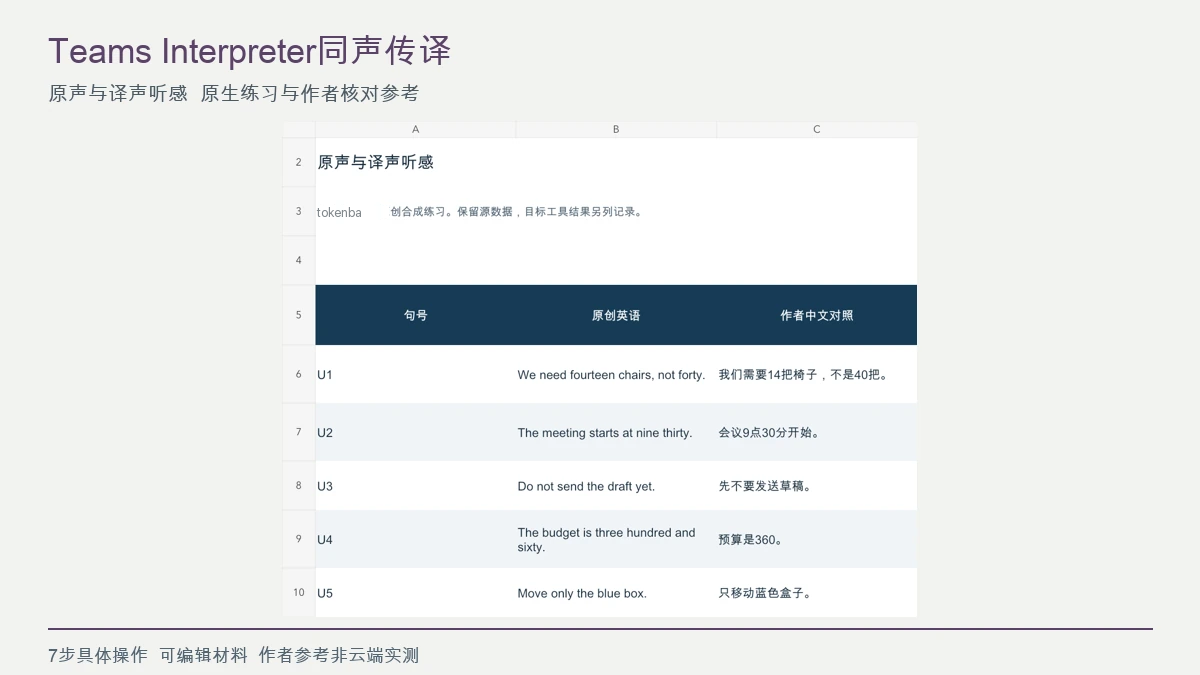
在授权测试会议确认语言和许可,启用 Interpreter 并选择实际可用译声,调整原声/译声比例后轮流说话。回听数字和否定,字幕正确不能代替可听翻译正确。
阅读文章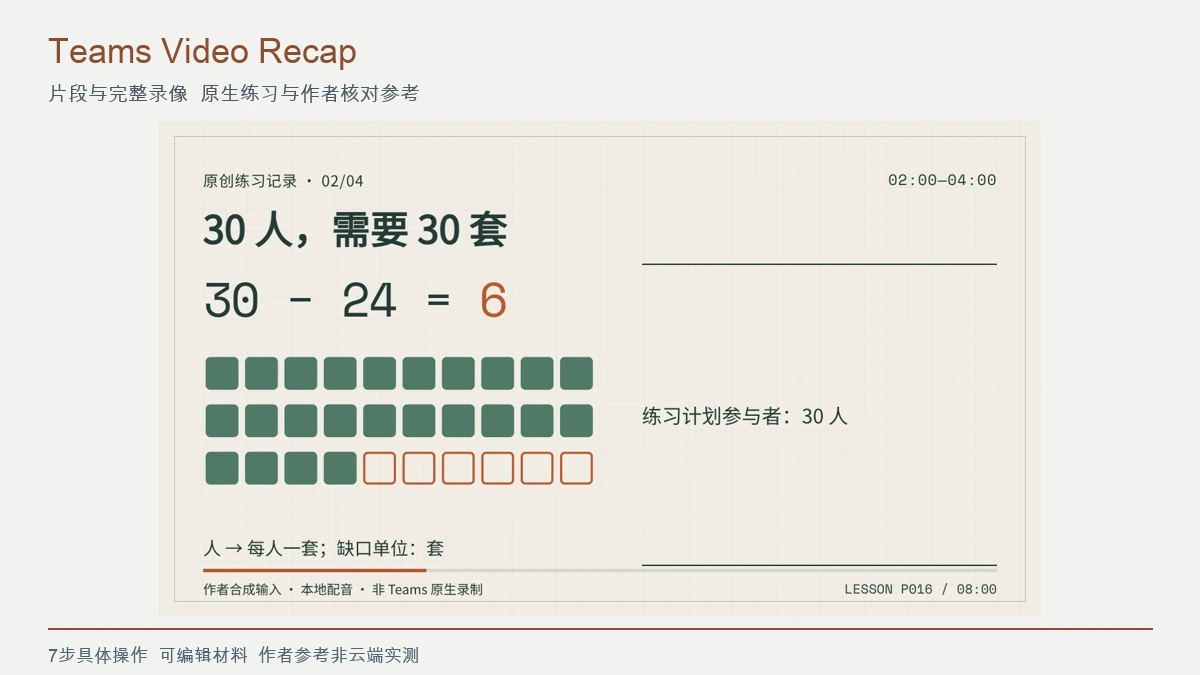
从有授权录制的会议进入当前 Video Recap,按主题播放实际片段,再跳回完整录制检查上下文。把仍需审批的事项标为待决,不能因短片漏句写成已采购;包内输入不代表完成线上录制。
阅读文章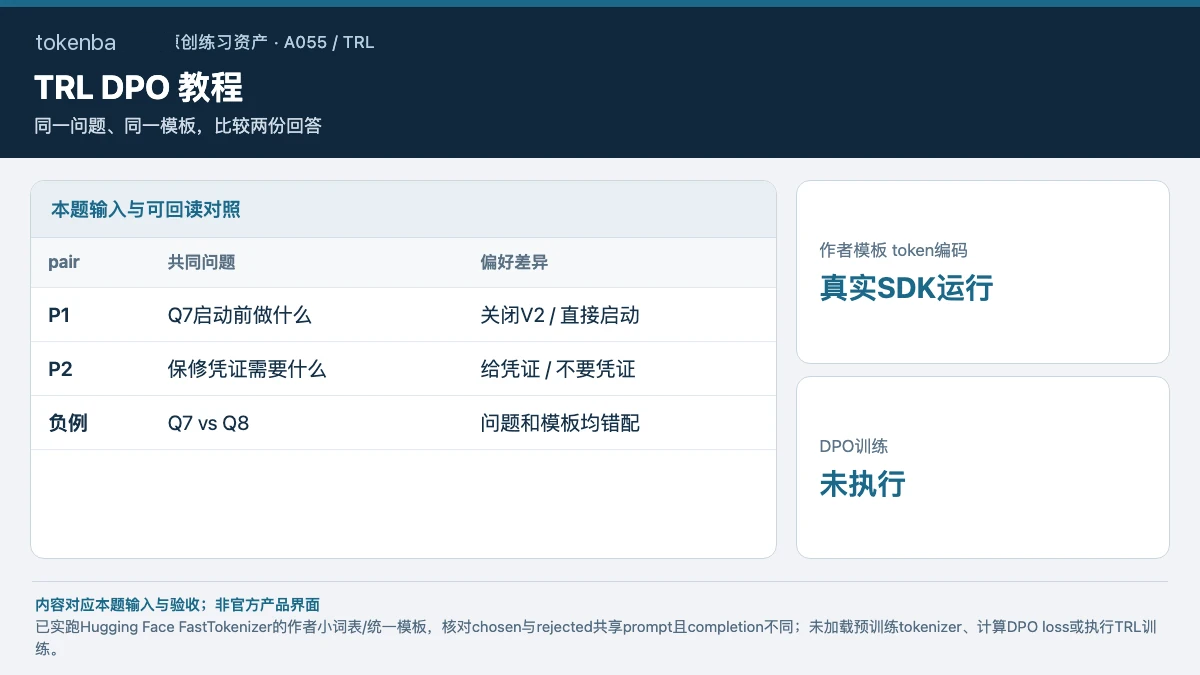
在 TRL DPO 为 chosen 与 rejected 共用一份 prompt,使用同一 tokenizer、chat_template 和特殊 token。保存共同前缀与回答边界,检查截断没有抹去两边差异,再进入训练。
阅读文章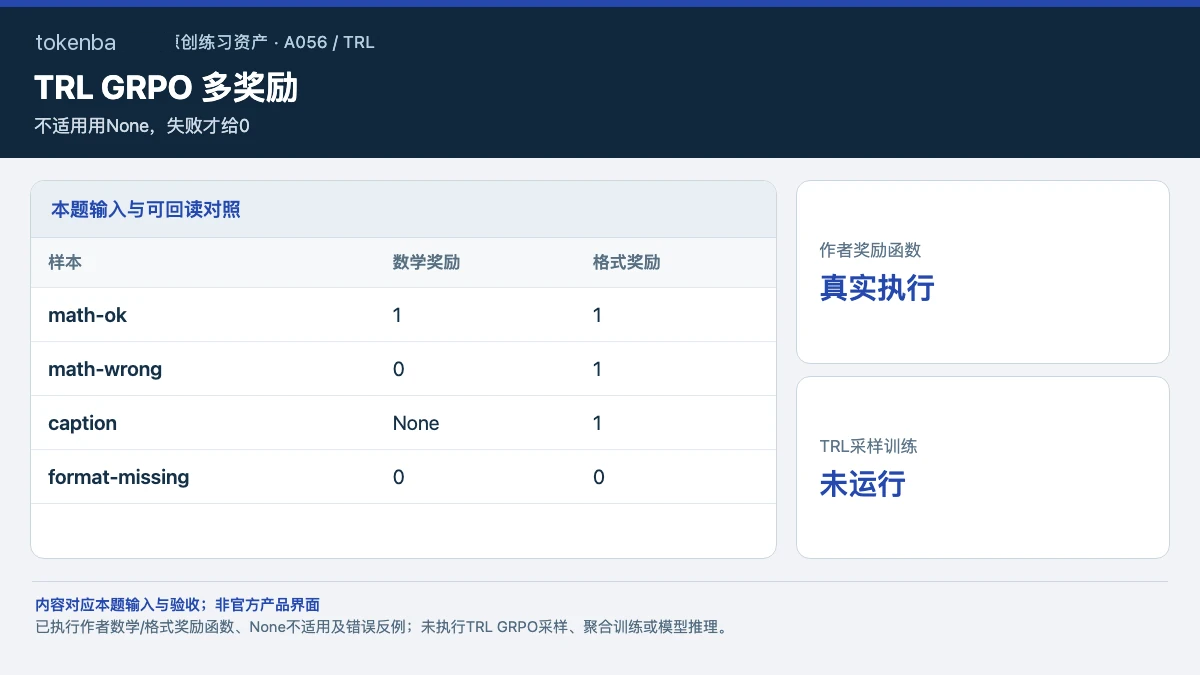
在 TRL GRPO 将数学正确与格式完整写成独立 reward_funcs,非数学样本的数学奖励返回 None。采样后保存每条 completion 的分项得分,标签完整但算错与无适用奖励分别处理。
阅读文章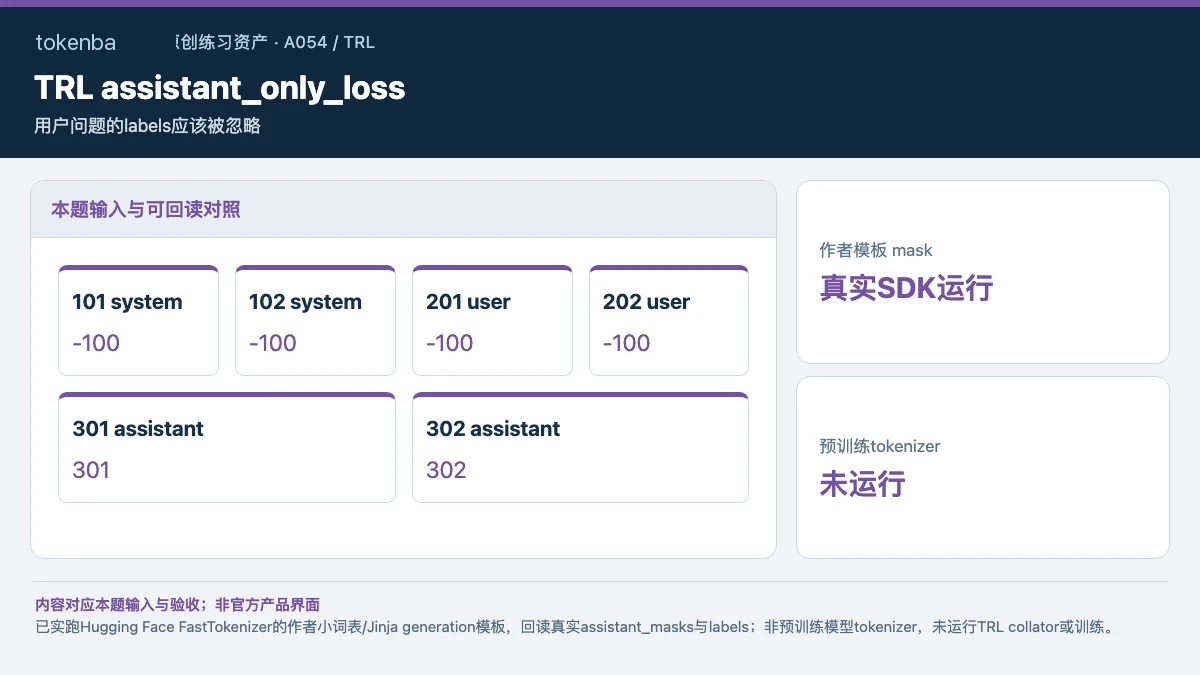
在 TRL 使用支持 generation 掩码的聊天模板和 assistant_only_loss=True,训练前读取实际批次的 input_ids 与 labels。逐 token 核对 system/user 为 -100、assistant 有监督,截断后不能变成全 -100。
阅读文章
在 Unsloth 用真实训练模型执行官方 GGUF 导出,保存 tokenizer、聊天模板、停止词和量化设置。用相同多轮案例对比源模型与目标 runner,检查角色串位、上下文丢失和不停止,再保存实际模型文件摘要。
阅读文章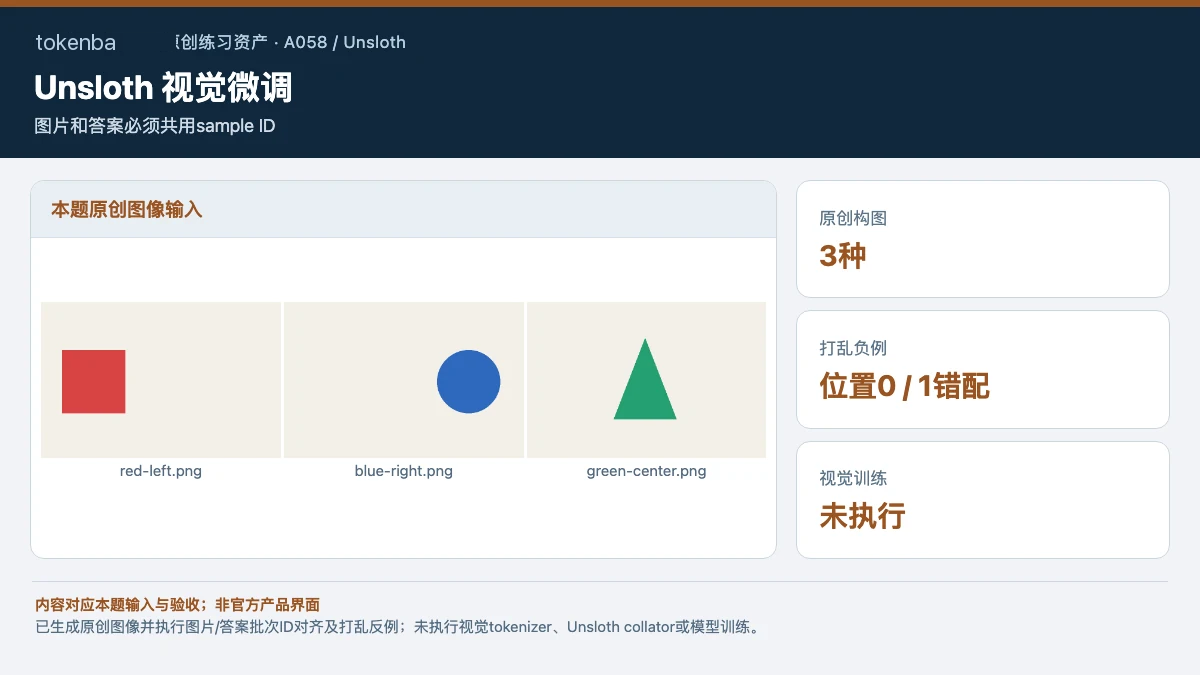
把自有图片和答案按稳定 ID 构造成视觉消息,先审配对与打乱负例,再用真实视觉 collator 检查一批。确认裁剪影响后才训练,留出独立评估;本地配对校验不等于模型微调完成。
阅读文章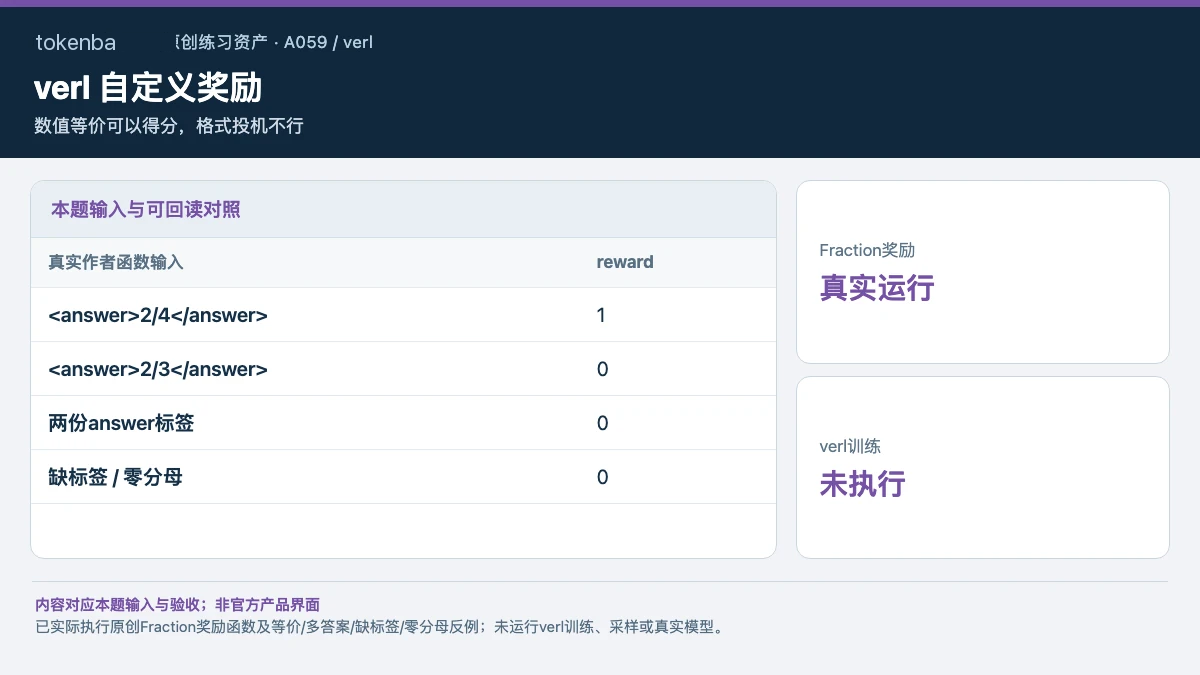
为 verl 的 compute_score 实现单一 answer 标签与 Fraction 等价比较,先离线测试1/2、2/4、多答案、缺标签和零分母。格式投机不得误奖,真实训练后仍按 completion 与 ground_truth 回查分数。
阅读文章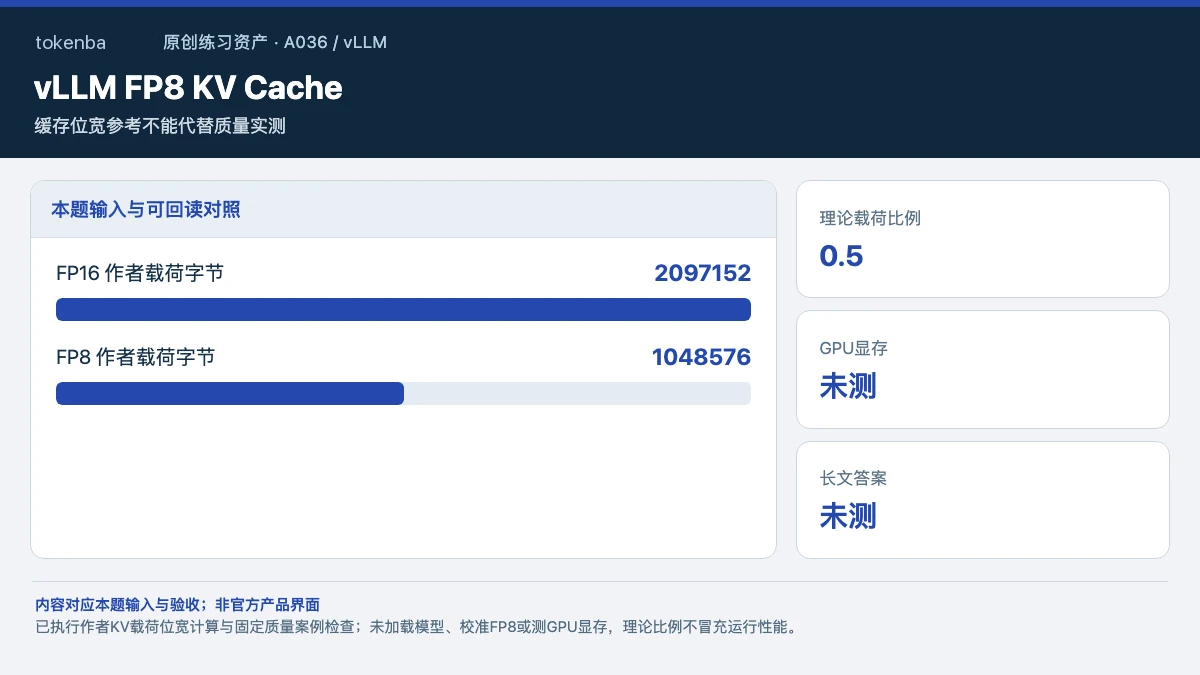
在同一 vLLM 底座先跑 auto KV cache 基线,再启用支持的 FP8 与校准 scale。固定长短文问题、采样与上下文,比较真实显存和关键答案遗漏,理论位宽减半不等于整机显存减半。
阅读文章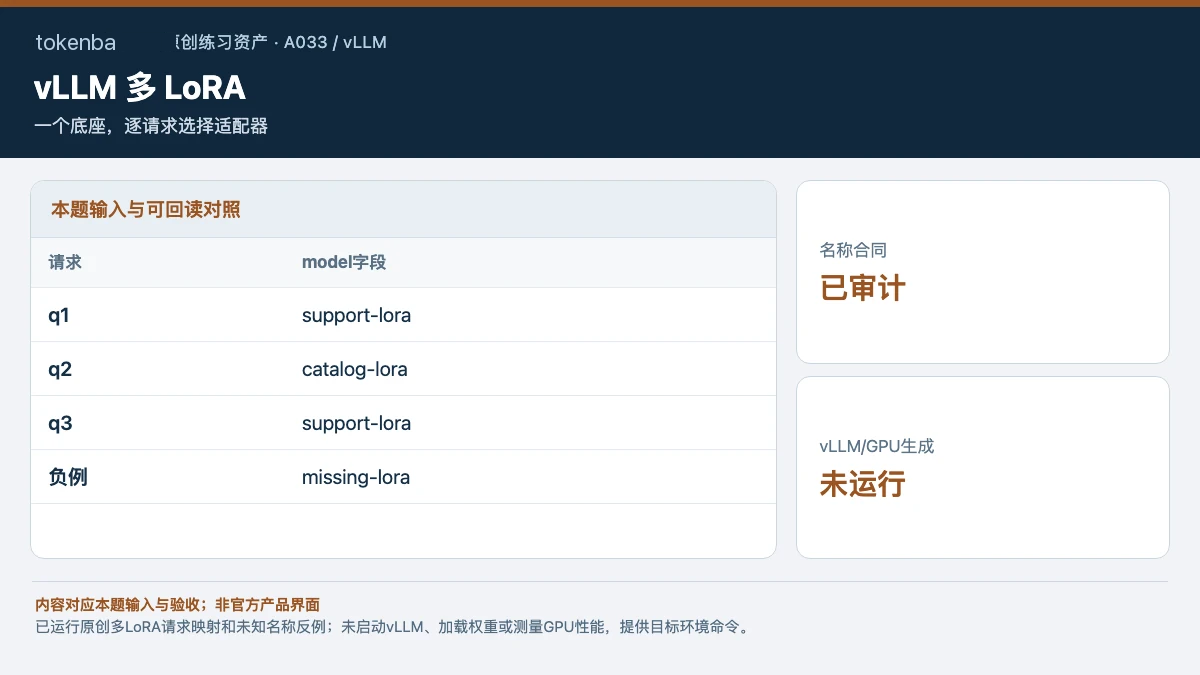
在合适GPU环境加载与底座兼容的适配器,用enable-lora和命名lora-modules启动服务,再通过每次请求的model选择适配器。交替请求两套任务并保存实际model与服务日志,未知名称应失败;离线映射不证明权重已加载或GPU性能。
阅读文章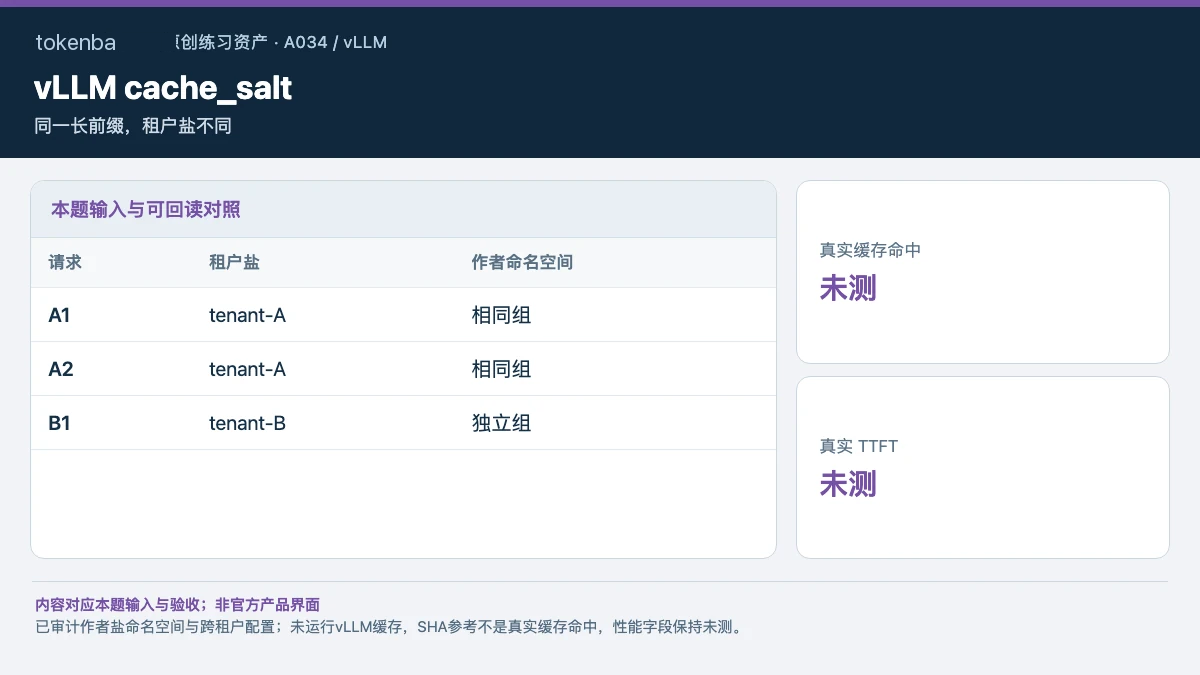
在 vLLM 开启 prefix caching 后,用同一长前缀先发送 A1/A2 相同 cache_salt,再只为 B1 更换租户盐。回读真实缓存 token、指标与延迟,确认组内复用和跨组不复用,不能只看第二次变快。
阅读文章
先比较两版书稿并审阅 chapter/span 计划,生成版本 A 后保存各章摘要。只替换第二章一段再生成 B,核对未改章节是否复用;包内缓存表不是目标引擎执行结果。
阅读文章
记录本机硬件与语言,分别检查两个引擎的安装、加载和激活状态,再显式切换用同一句台词合成。保存实际引擎标识和音频;能安装不等于已加载或正在使用。
阅读文章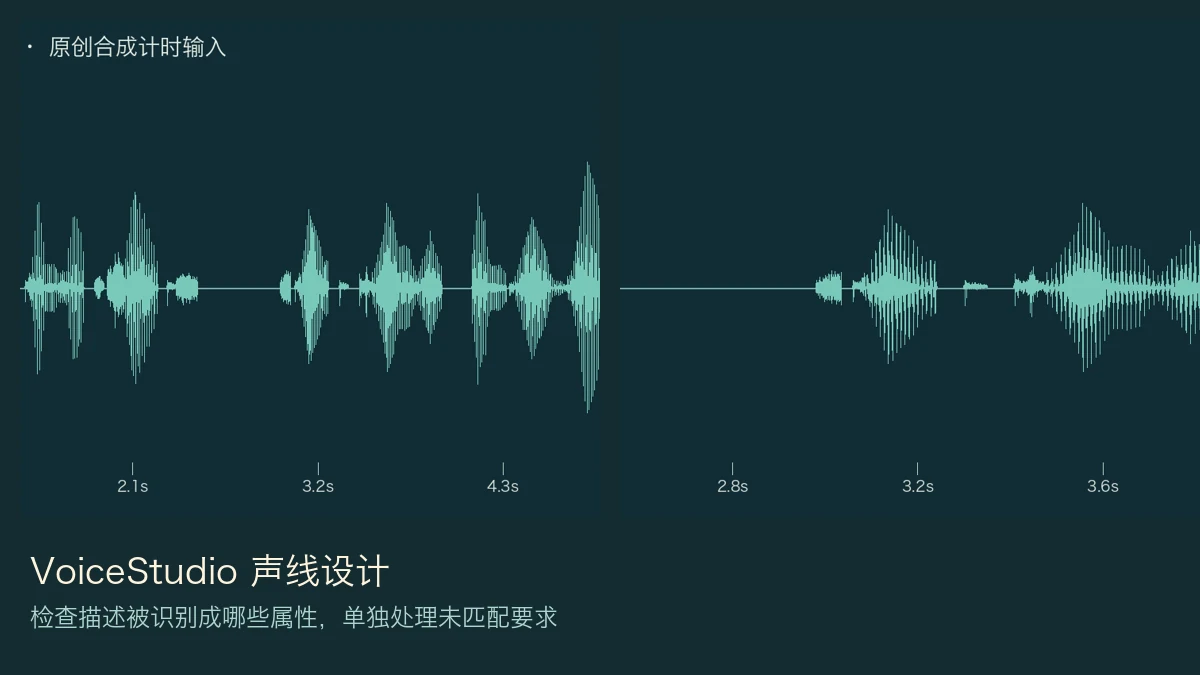
把虚构声线描述送入 design/describe,分别保存 attrs 与 unmatched,再只改一个可识别属性到兼容引擎试听。
阅读文章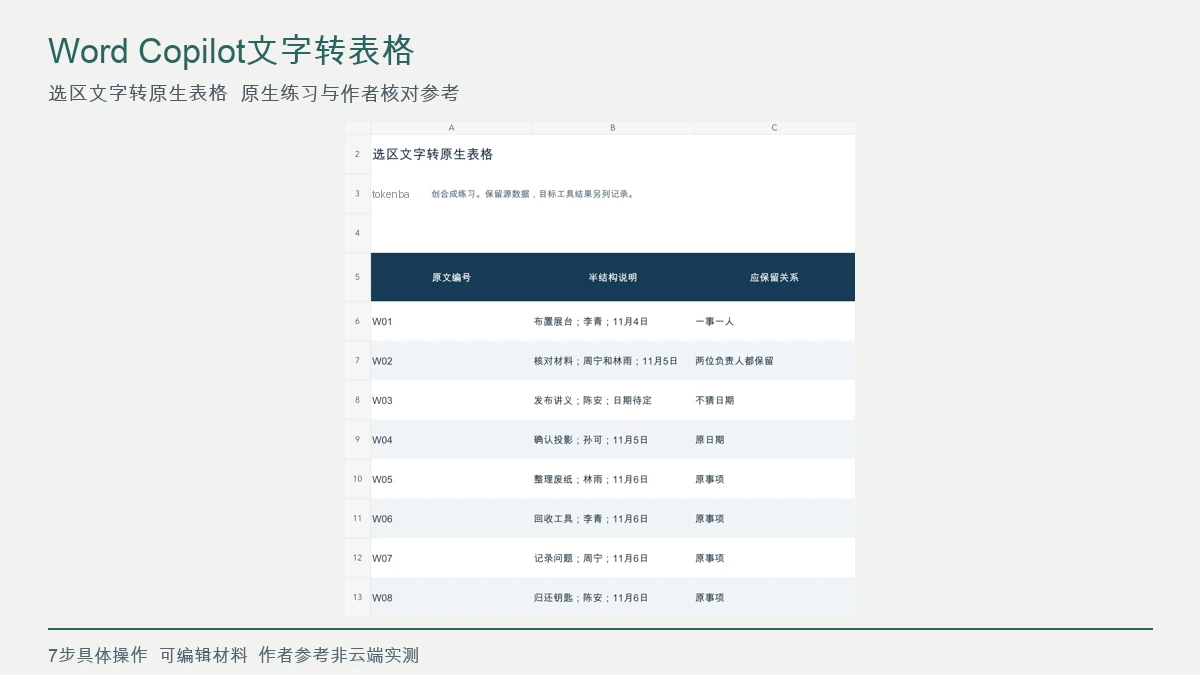
八条事项应全部保留,W02两位负责人都在,W03仍待定;生成后必须能直接编辑表格单元格。
阅读文章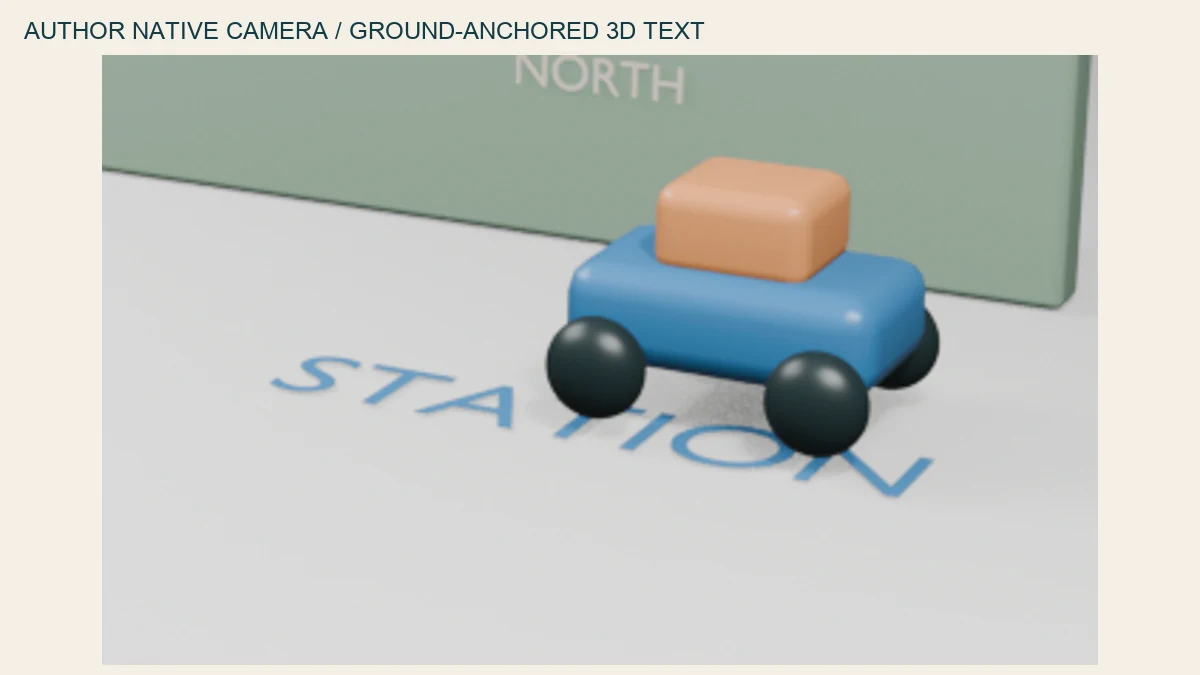
选有真实视差的片段运行 3D Camera Tracker,排除移动主体,设地面与原点后创建 3D 文字。随镜头播放检查滑移和消失点;平面文字看似贴地不证明求解摄影机准确。
阅读文章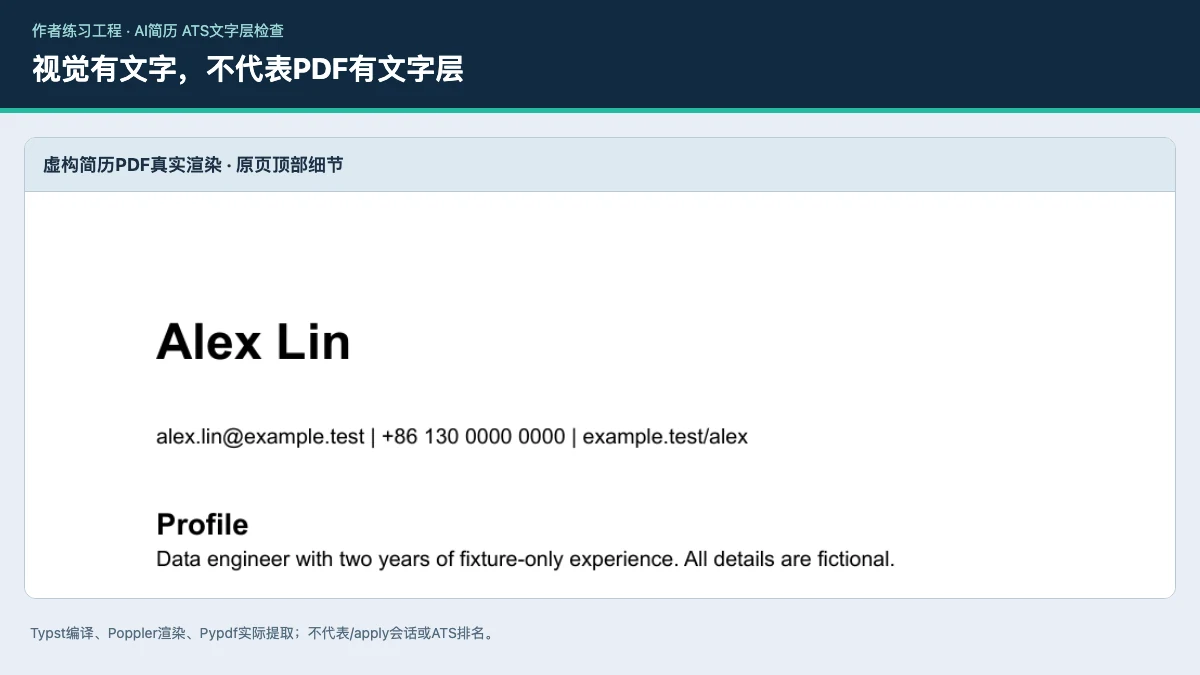
从 AI Job Search 自定义模板导出可选择文字的简历 PDF,再提取文字层核对联系方式、日期与章节顺序。把纯图片 PDF 作为反例,检查视觉正常但无法提取文字的差异;本课不预测 ATS 分数。
阅读文章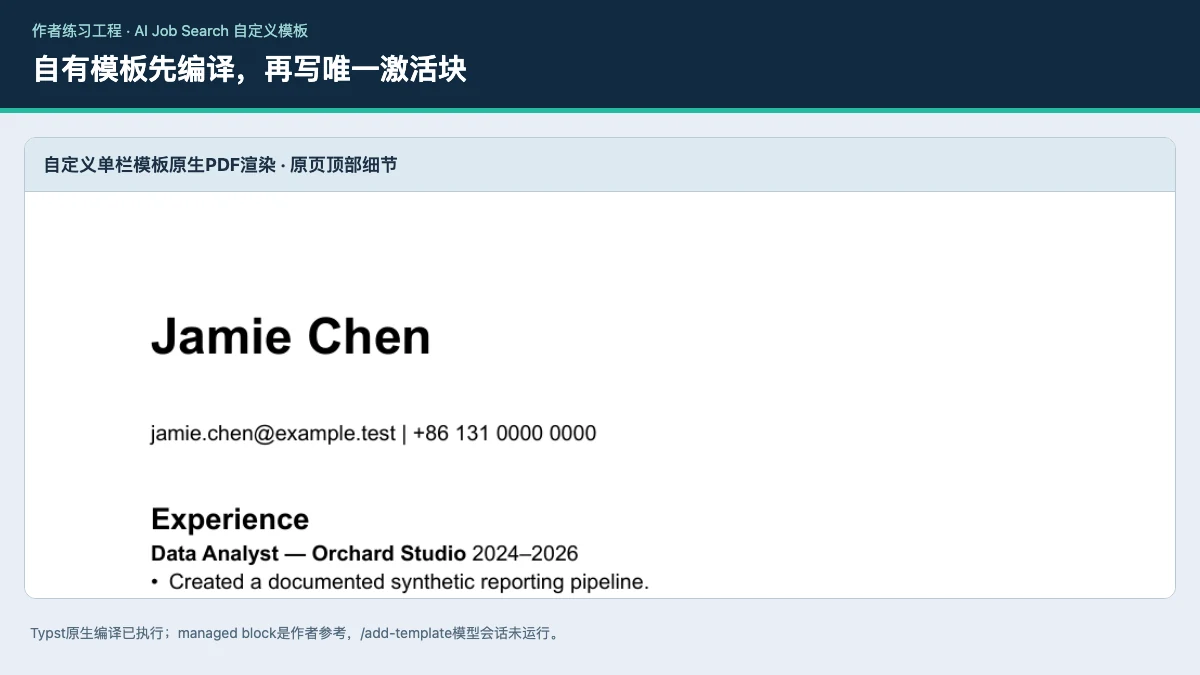
为 AI Job Search 新建独立 CV 模板目录,在 TEMPLATE.md 写清扩展名、字体、页限与真实编译命令。用虚构资料先编译一页 PDF,再按注册说明只保留一个激活块,并验证编译失败不会残留旧 PDF。
阅读文章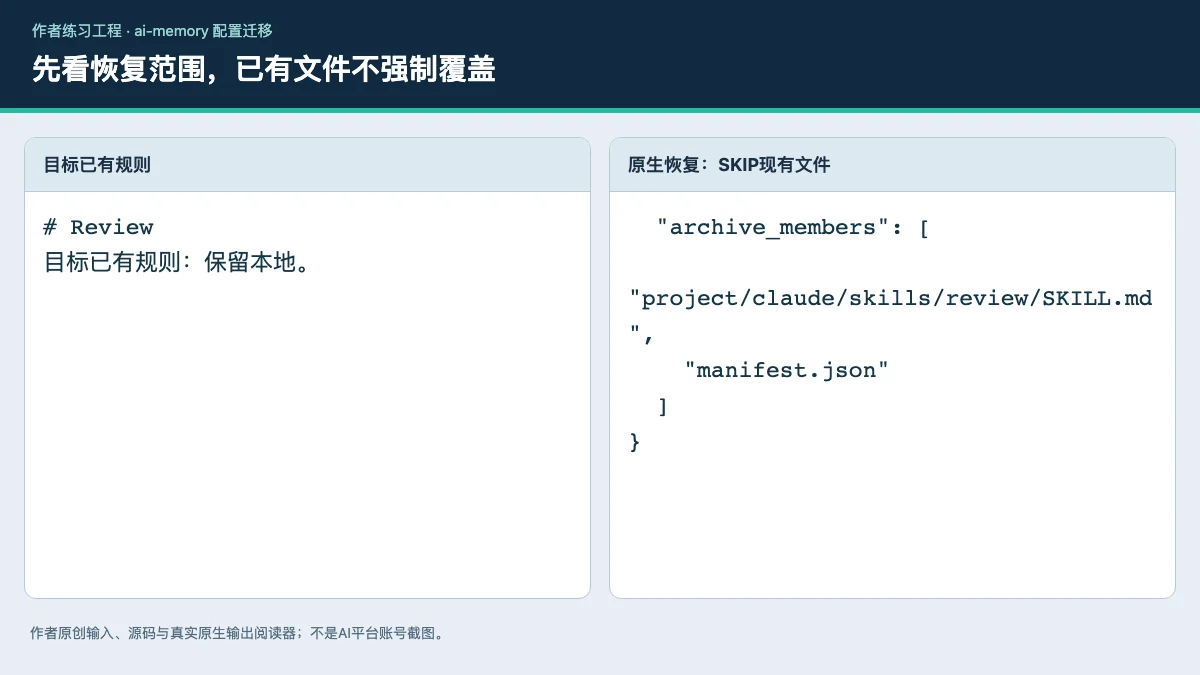
backup-agents仅备份项目级Agent资产,先查看归档manifest,再运行restore-agents默认dry-run。确认范围后不带force执行apply,已有不同文件应保留;需要覆盖时另行备份并核对,不能拿摘要文件冒充资产迁移。
阅读文章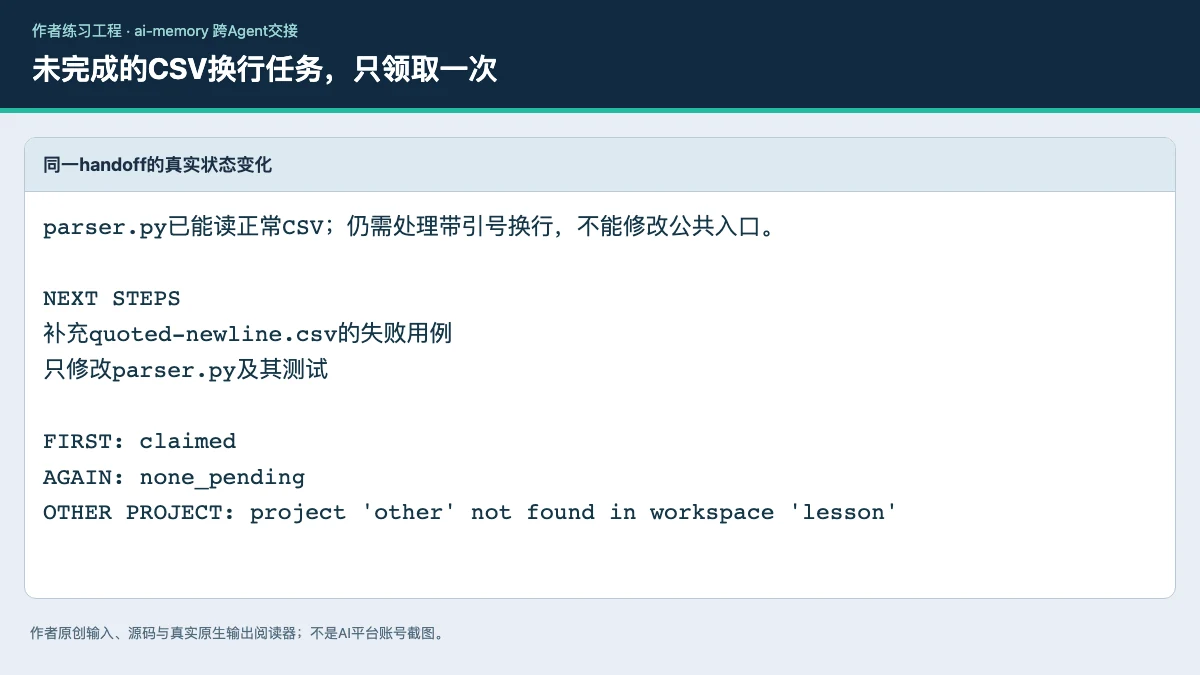
每次调用同时带workspace和project,用memory_handoff_begin保存未完成项并记录handoff_id,接手端用同作用域accept。再测原样重复领取和其他项目领取,分别检查不会重复执行、不会跨项目接手。
阅读文章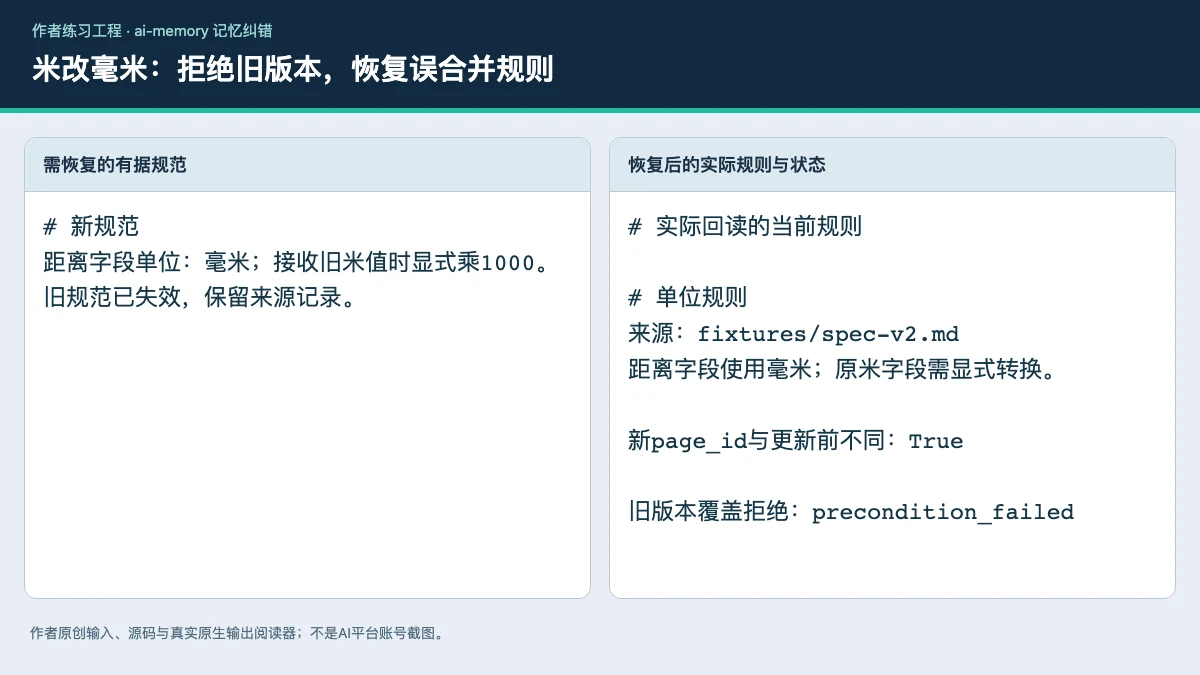
在 ai-memory 先回读 page_id,再以 expected_page_id 写入带来源的新单位规则,保留 Git checkpoint。用旧 page_id 触发陈旧覆盖拒绝,再按正确修订号调用 memory_restore_page 恢复误合并页。
阅读文章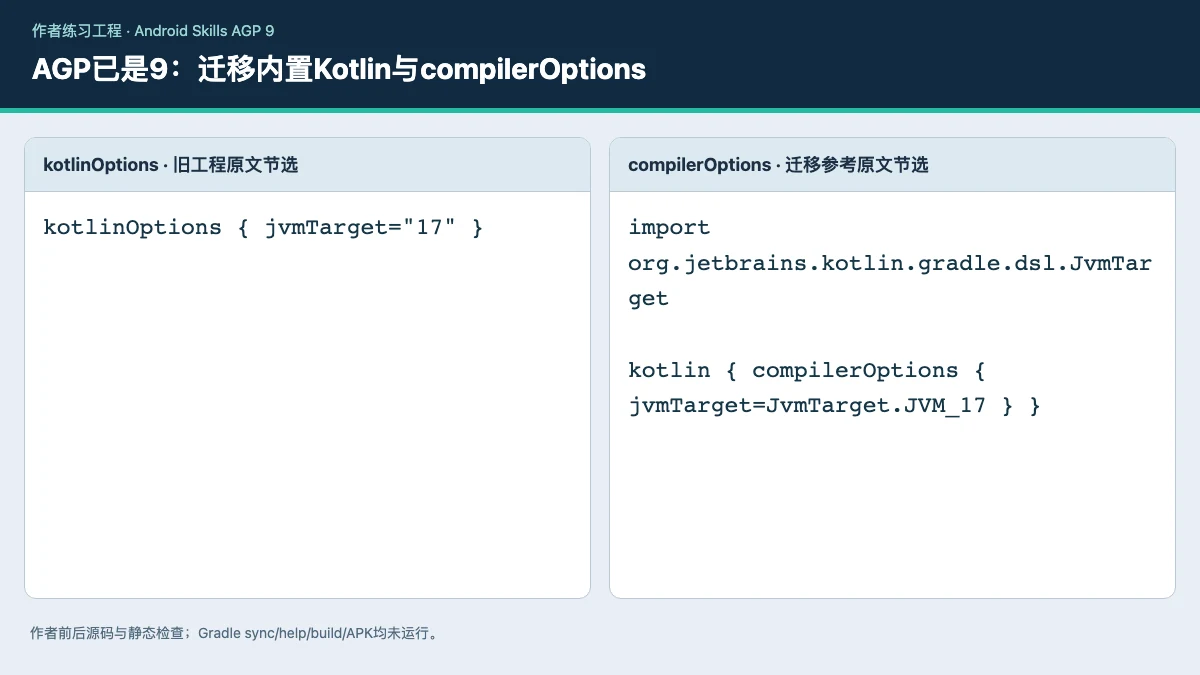
输入工程已是AGP9.0.1且非KMP;已完成源码合同对照,未执行Gradle IDE sync、help、build dry-run或APK构建,不把静态检查当原生迁移成功。
阅读文章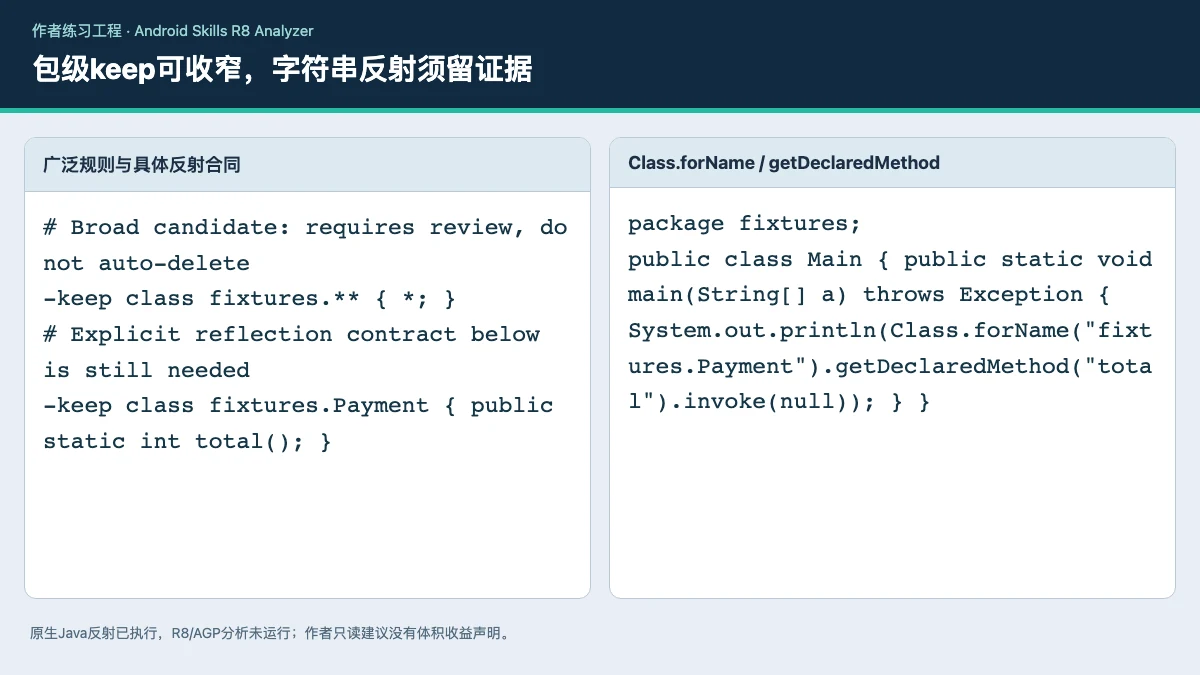
让 Android Skills R8 Analyzer 只读盘点 keep 规则,先追溯包级保活与具体成员的来源。将宽泛规则列为精简候选,把 Class.forName 和 getDeclaredMethod 的真实反射依据单列,构建验证前不宣称缩包收益。
阅读文章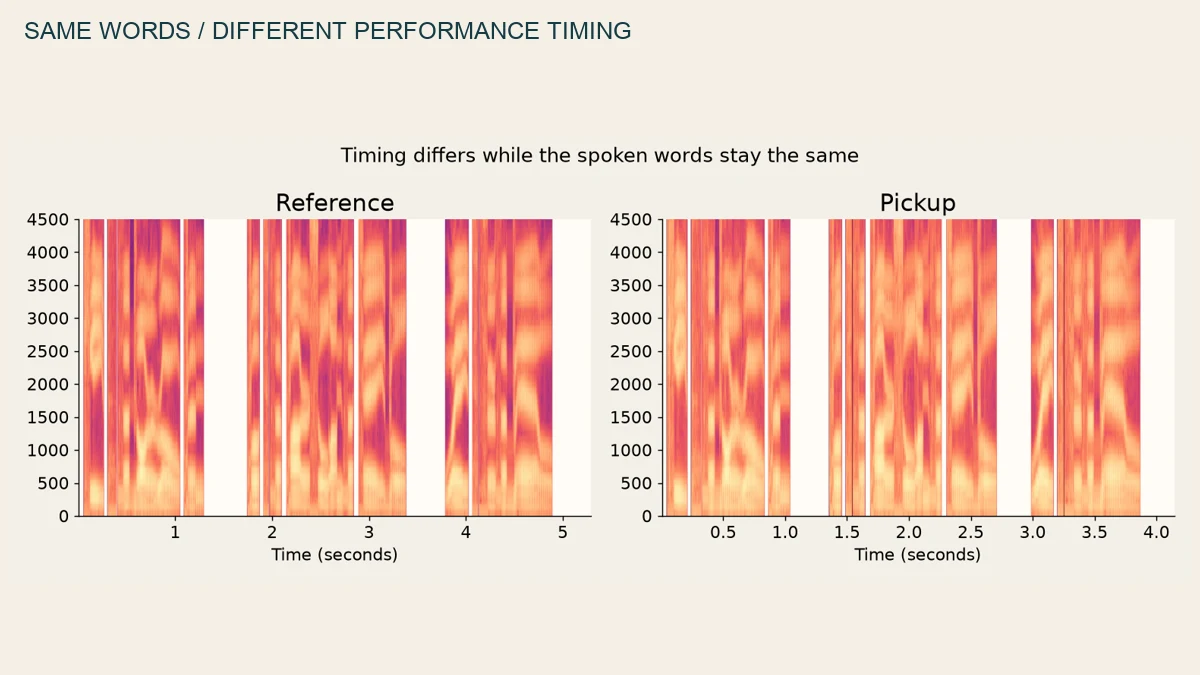
将同文参考与补录安排在独立轨,运行 Automatic Speech Alignment 后逐音节回听关键字和接缝。保留未处理补录,匹配整体长度不等于每个音节都没有被拉坏。
阅读文章
建立标题、示意图、按钮三层,先设页面总时长,再试 Magic Animate 并调整各元素进入时点。保留最后一屏阅读停留,导出后完整播放;漂亮动画不代表信息顺序清楚。
阅读文章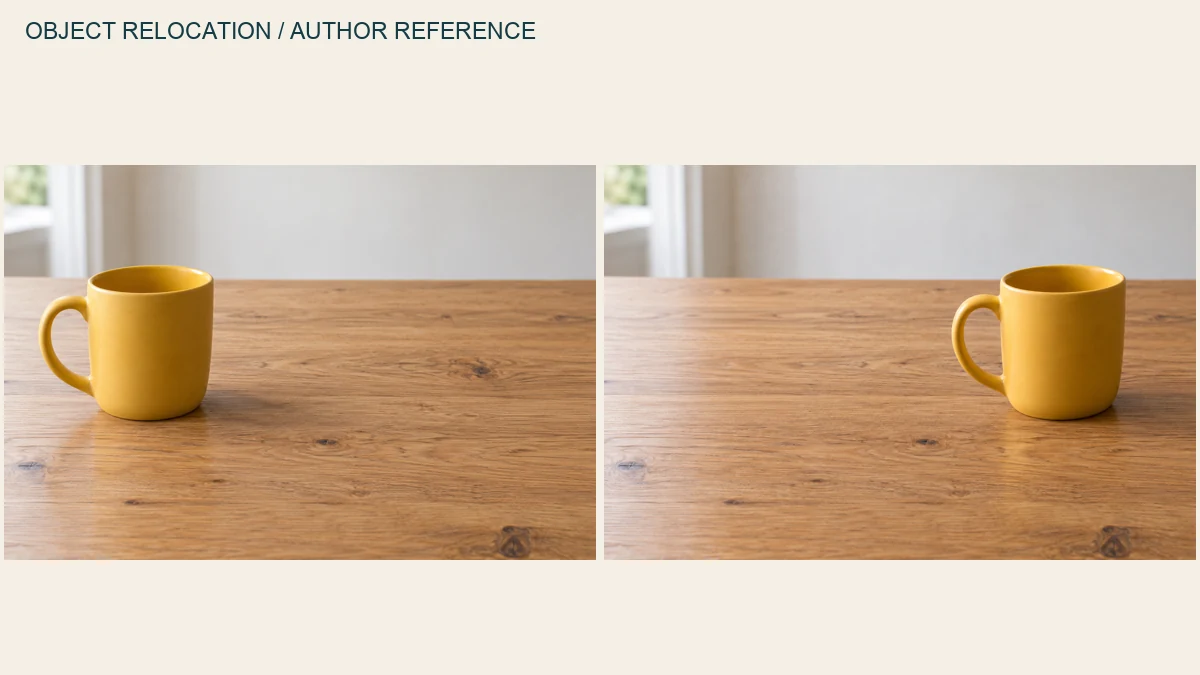
导入完整桌面图,在 Magic Grab 中选中杯子并移动到右侧留白。分别检查旧位置木纹补全、新位置杯把边缘和重复残影,再保存实际结果;练习参考不是 Canva 云端输出。
阅读文章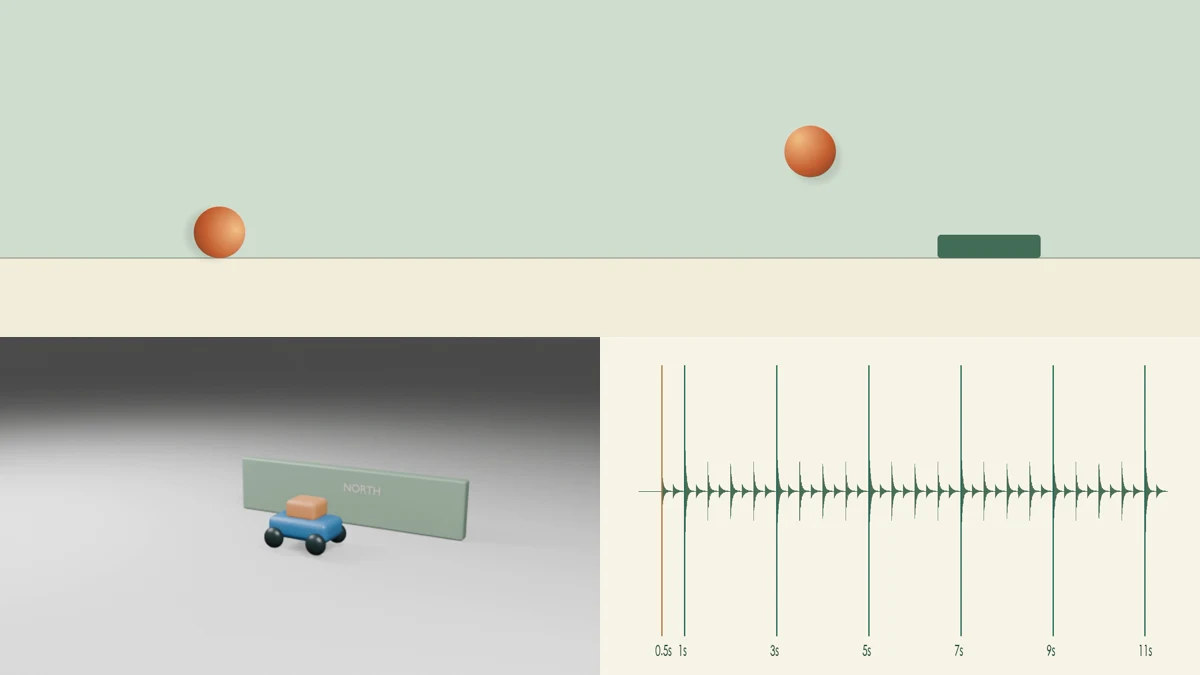
在支持的手机端 AutoCut 选择六段动态原片,进入实际 Beat/Music Beat 路线后换上原创音轨。比较每拍与强拍选段,逐点复听弱拍引子;人工切点参考不能冒充 CapCut 自动卡点输出。
阅读文章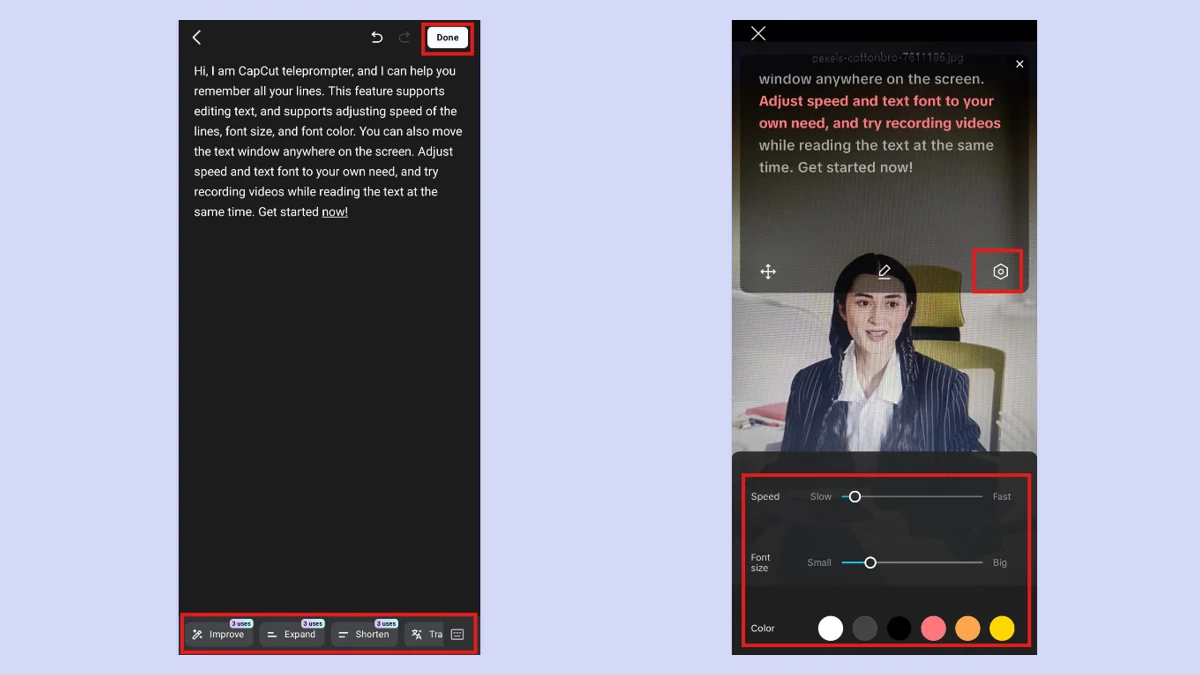
CapCut AI 提词器手机教程:从164字原稿缩短到88字作者参考,核对事实后调整字号、滚速与镜头,录十秒检查视线和提词文字。附官方截图、原创讲稿与记录表。
阅读文章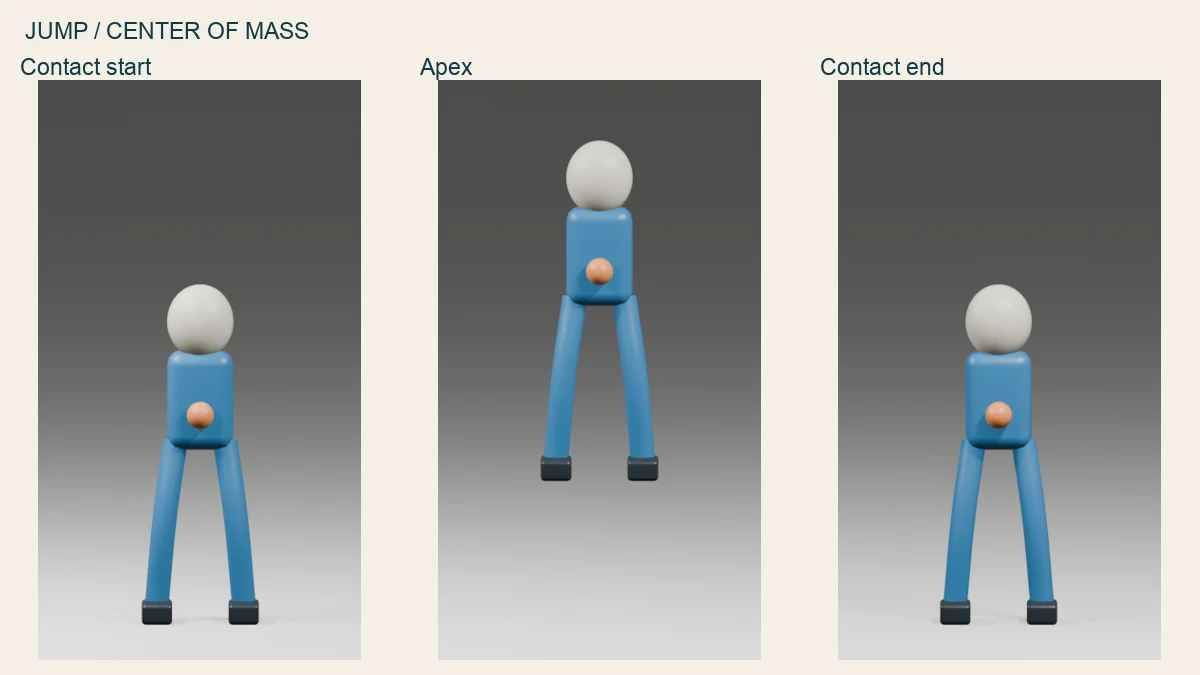
给跳跃动画设置支撑与腾空区间,用AutoPhysics参考检查重心轨迹和落地接触。
阅读文章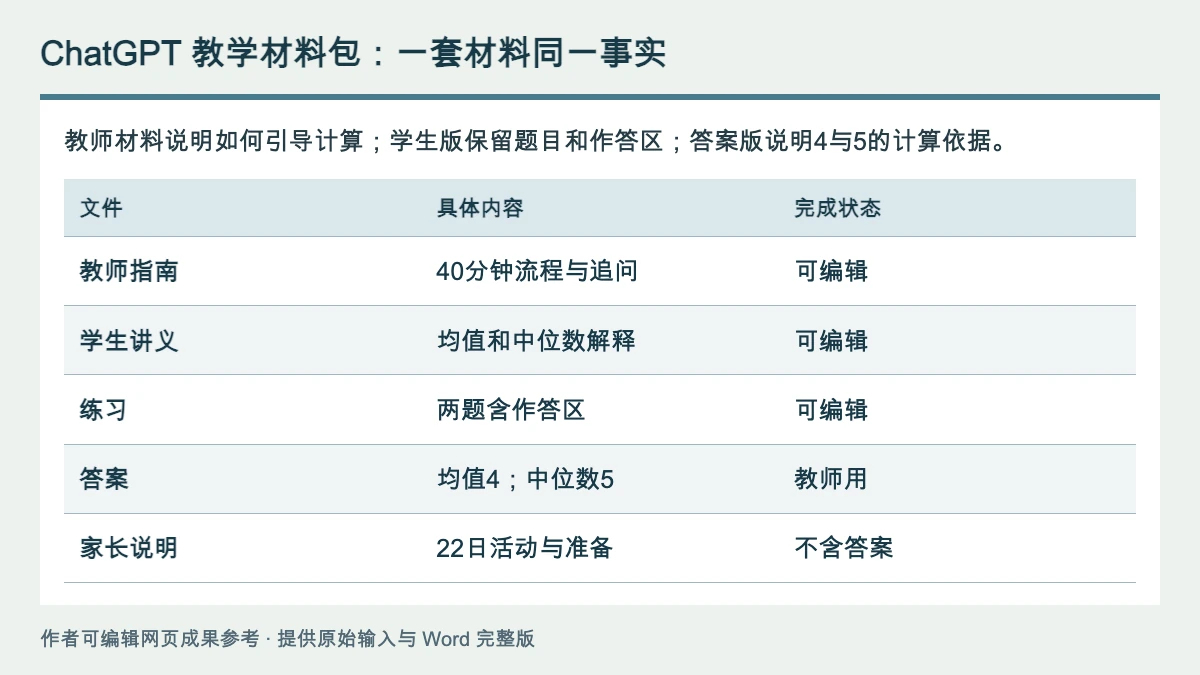
把同一份已批准课例交给 ChatGPT,分开制作教师讲义、学生练习、答案与家长说明。按题号核对答案和共同日期,家长版只写目标和准备事项,不能混入答案。
阅读文章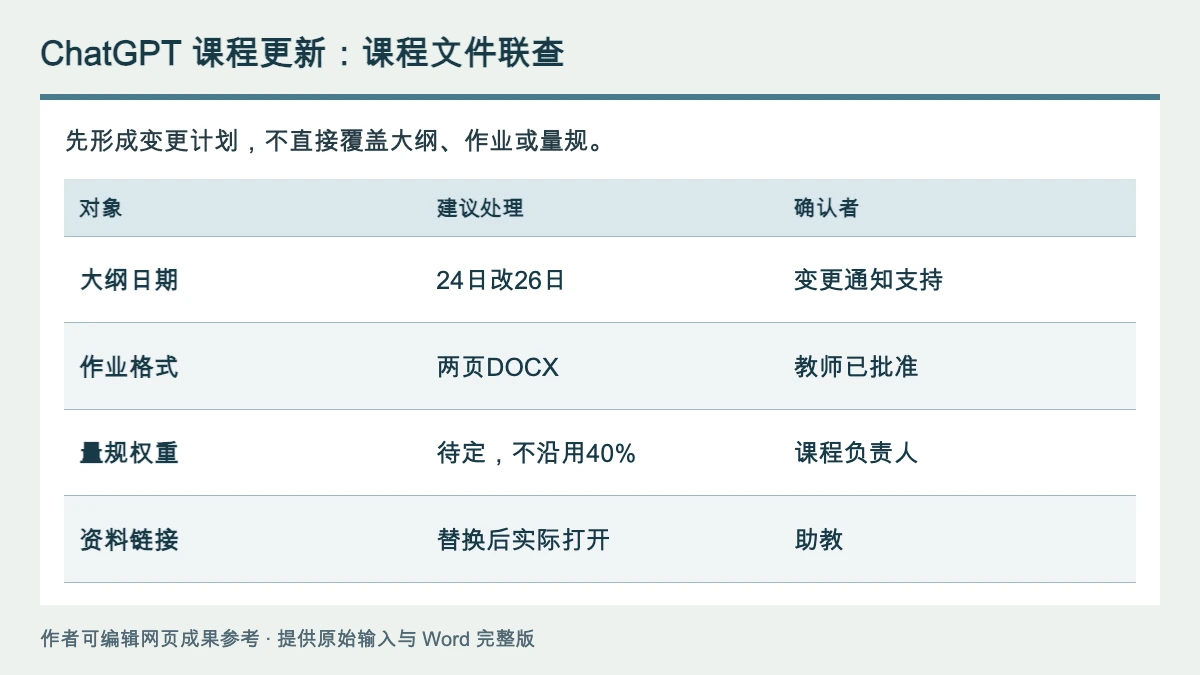
同时提供课程大纲、作业、量规和变更通知,先让 ChatGPT 输出跨文件修订计划。截止日和文件格式按已确认通知修改,40% 等未批准权重留给教师决定,再按依赖顺序更新文件。
阅读文章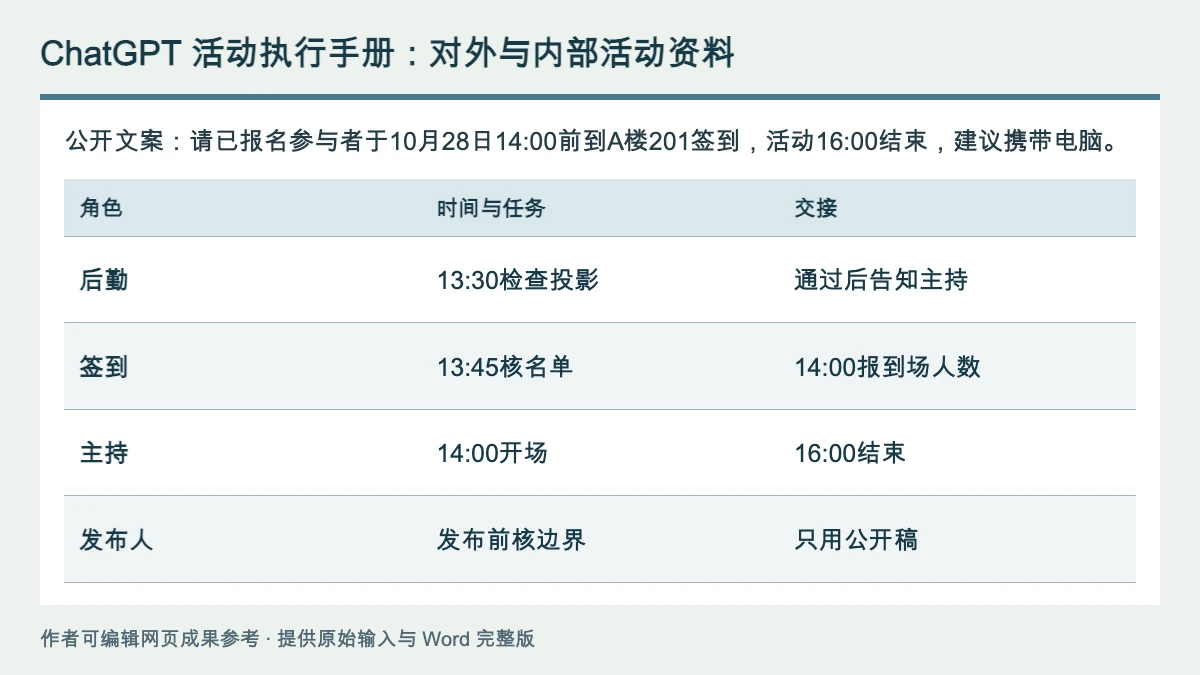
让 ChatGPT 基于已批准公开字段和内部安排分别生成参与者文案与执行手册。两版日期地点一致,内部 600 元茶歇预算与联系人只留在负责人文件,不进入公开稿。
阅读文章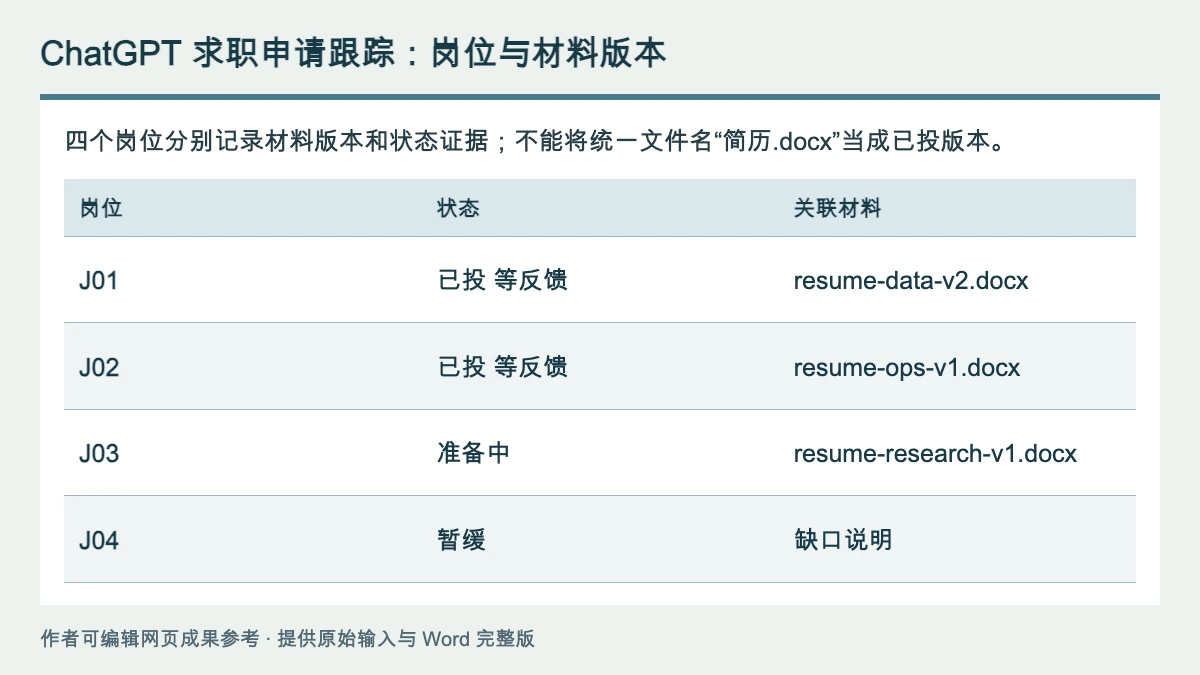
把四份 JD、简历版本和申请回执按岗位 ID 关联到一张跟踪表。只有回执证明的记录标已投,准备中的岗位保留下一步;同名简历按内容和版本区分。
阅读文章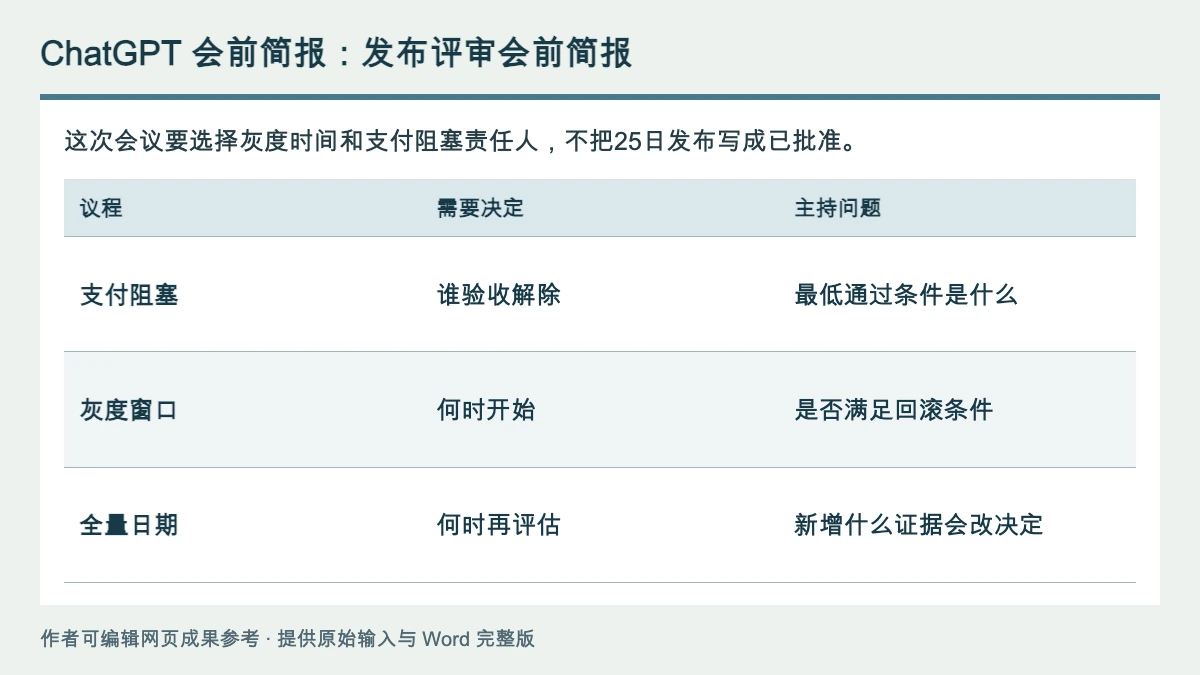
把会议日程、两份预读和沟通记录交给 ChatGPT,先分已知、未决和冲突,再形成议程。25 日发布只是提案,支付回归和先灰度约束须进入待决问题。
阅读文章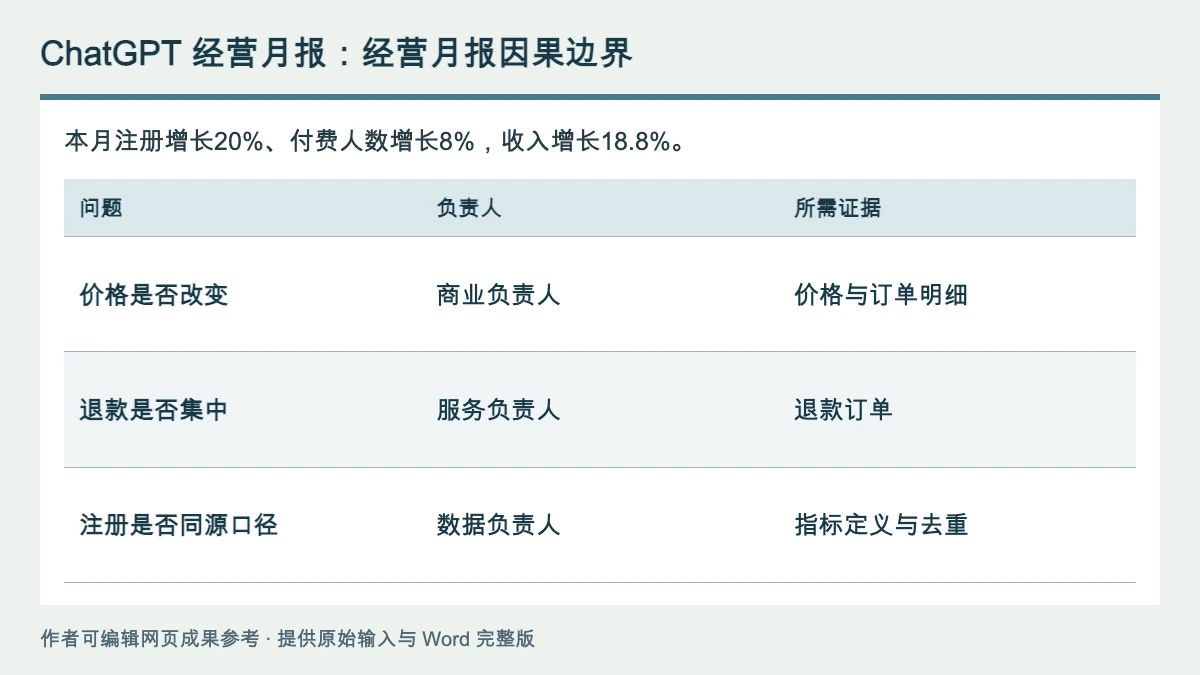
给 ChatGPT KPI 定义、原始月数据和负责人说明,先复算注册 20% 与收入 18.8% 的变化,再写月报。负责人解释标为原因假说,退款增长 80% 继续按原订单与金额追查。
阅读文章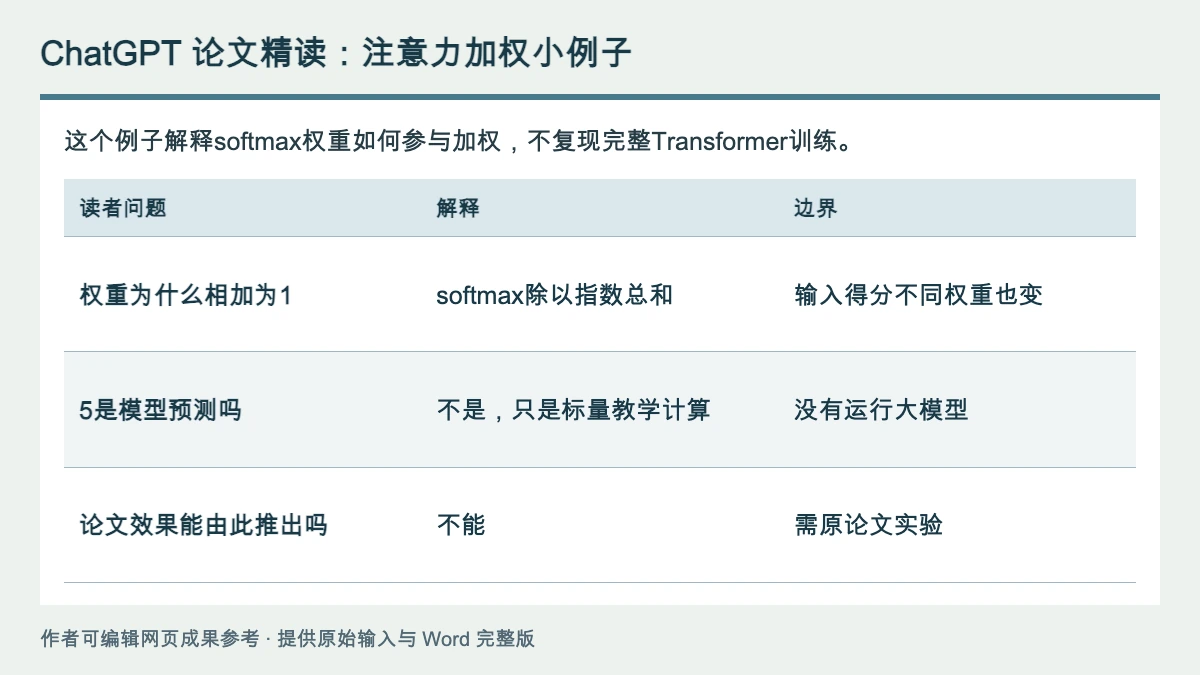
将论文与自己的基础交给 ChatGPT,先补齐 softmax 和加权求和概念,再用 0 与 ln3 得到 1/4、3/4 权重,把 2 与 6 加权得到 5。该小例子只解释概念,原论文的投影和多头结论仍需回到正文。
阅读文章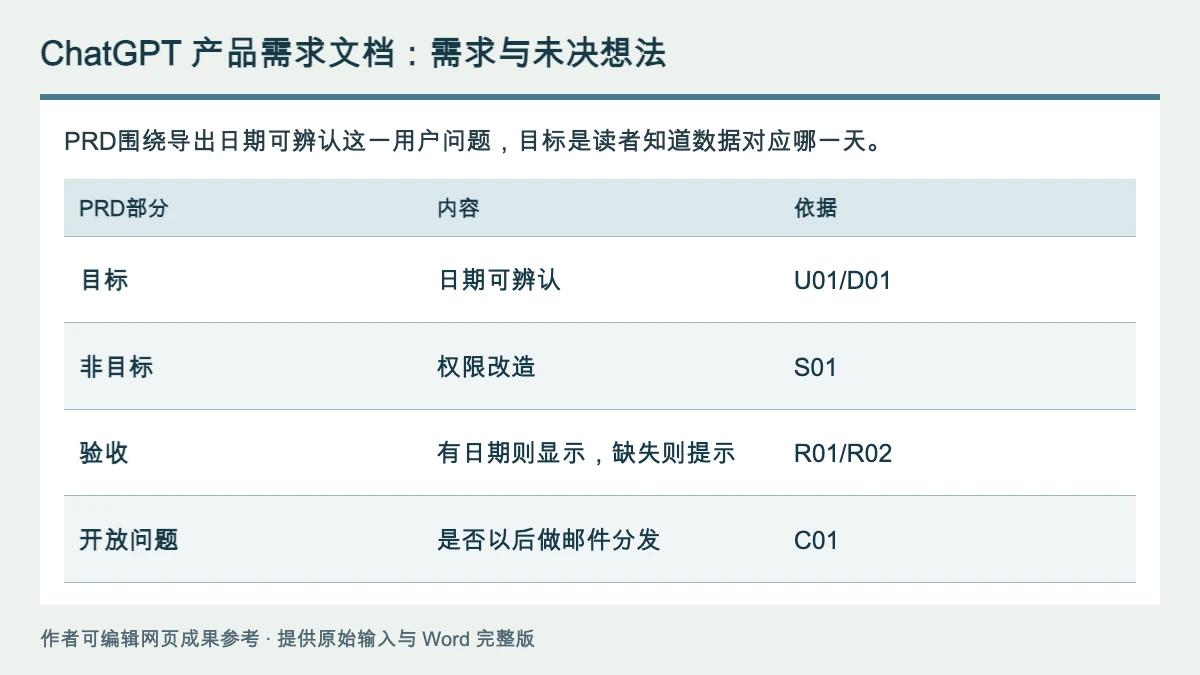
让 ChatGPT 将用户反馈、已批准决策与讨论逐条关联,先划分确定范围、非目标和开放问题,再写 PRD 验收条件。自动邮件只是讨论过的想法,不能未经批准变成确定需求。
阅读文章注册后创建 apizt API Key,选择客户端和模型,再生成接入配置。从一次简单请求开始,按实际用量付费。
在控制台创建令牌,选择需要使用的模型权限。
按工具要求填写 API Key、接口地址与模型 ID。
确认收到有效结果,再到控制台查看用量与费用。